GPT-6 проти Claude 5.5: що найкраще для бізнесу?

Ngoc Hong
16 жовтня 2026 р.
Порівняйте GPT-6 і Claude 5.5 для кодування, досліджень і бізнес-процесів. Дізнайтеся, яка AI-модель найкраще відповідає потребам вашої команди, бюджету та цілям продуктивності.
GPT-6 проти Claude 5.5: що найкраще для бізнесу?
GPT-6 проти Claude 5.5 — це порівняння, важливе для бізнесу, який вирішує, які AI-моделі впроваджувати. І OpenAI, і Anthropic пропонують потужні моделі для кодування, досліджень, аналізу документів і складних професійних завдань. Але сильніші результати бенчмарків не завжди означають кращі бізнес-результати.
Для AI-лідерів, команд інновацій і агентств з автоматизації рішення має враховувати продуктивність, надійність, вартість і сумісність із робочими процесами.
Цей гайд порівнює GPT-6 і Claude 5.5 на основі опублікованих бенчмарків, офіційних специфікацій моделей і практичних бізнес-кейсів.
GPT-6 проти Claude 5.5: ключові відмінності коротко
GPT-6 і Claude 5.5 — це сімейства моделей, а не окремі моделі. Кожне з них містить варіанти для різних рівнів складності та вартості.
| Category | GPT-6 family | Claude 5.5 family |
|---|---|---|
| Developer | OpenAI | Anthropic |
| Flagship model | GPT-6 Astra | Claude Opus 5.5 |
| Professional work | GPT-6.1 Sol | Claude Sonnet 5.5 |
| Cost-efficient model | GPT-6 Luna | Claude Haiku 5.5 |
| Key strengths to evaluate | Advanced reasoning, coding, computer use | Complex analysis, coding, knowledge work |
| Main business consideration | Capability versus task cost | Quality, efficiency, and workload fit |
OpenAI позиціонує Astra для найскладніших завдань, а GPT-6.1 Sol — як майже флагманську модель за нижчою ціною. Anthropic позиціонує Opus для складних рішень, Sonnet для щоденної професійної роботи, а Haiku — для високонавантажених операцій.
Швидкий висновок: Claude Opus 5.5 випереджає GPT-6 Astra за кількома незалежними бенчмарками інтелекту та кодування. Водночас GPT-6 Astra може виконувати деякі бенчмарк-завдання з меншою кількістю токенів і нижчою загальною вартістю завдання.
Кращий вибір для бізнесу залежить від того, які компроміси для вас найважливіші.
Джерела: OpenAI GPT-6 Model Guide | Anthropic Claude Sonnet 5.5
GPT-6 проти Claude 5.5: бенчмарки — яка модель краща?
Незалежні бенчмарки допомагають бізнесу оцінювати можливості моделі без маркетингових заяв.
Artificial Analysis порівнює Claude Opus 5.5 і GPT-6 Astra за reasoning, кодуванням, автоматизацією, вартістю та швидкістю.
GPT-6 Astra проти Claude Opus 5.5: незалежні бенчмарки
Наведені нижче результати порівнюють обидві моделі в їхніх Max reasoning-effort configurations.
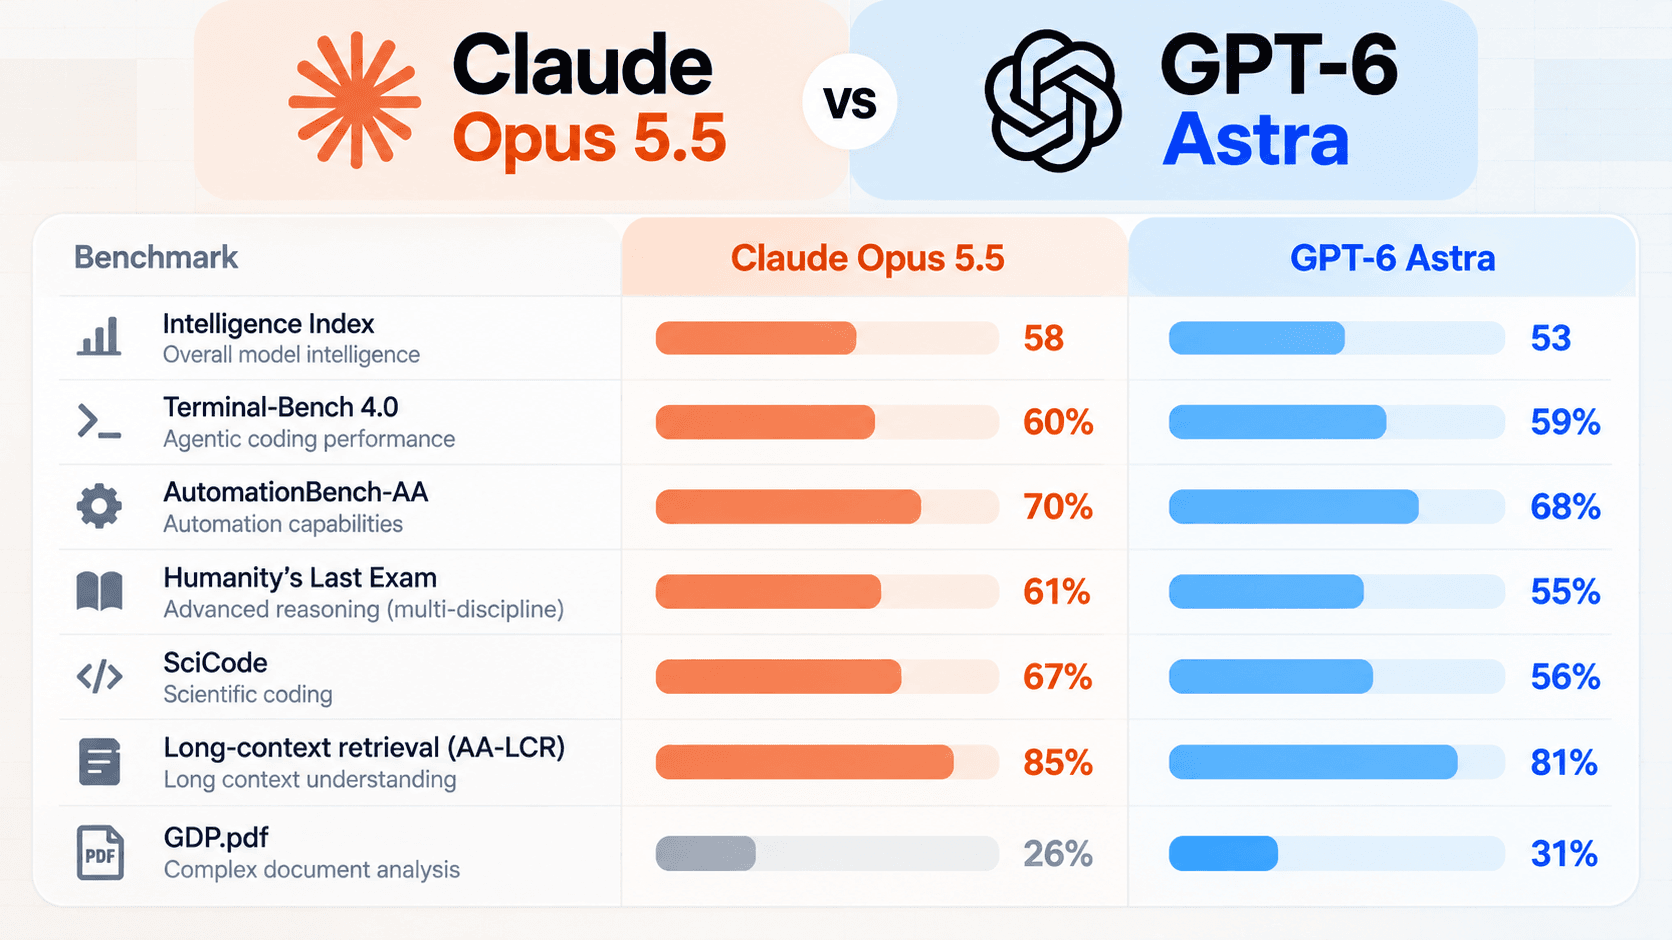
Джерело: Artificial Analysis — Claude Opus 5.5 vs GPT-6 Astra (Max)
Claude Opus 5.5 лідирує за загальним інтелектом, науковим кодуванням і кількома оцінками просунутого reasoning.
GPT-6 Astra краще працює на GDP.pdf, що показує: результати не є однозначно на користь Claude.
Ці оцінки також відображають конкретні конфігурації тестування. Інше налаштування reasoning-effort може змінити і продуктивність, і вартість.
Що означають ці бенчмарки для бізнесу?
Різні бенчмарки вимірюють різні можливості.
- Terminal-Bench 4.0: оцінює здатність AI-агента виконувати завдання за допомогою terminal-інструментів.
- AutomationBench-AA: вимірює продуктивність у завданнях, орієнтованих на автоматизацію.
- Humanity's Last Exam: перевіряє просунуті знання та reasoning у різних дисциплінах.
- SciCode: оцінює можливості наукового програмування.
- AA-LCR: вимірює точність пошуку в довгих контекстах.
Для агентства з автоматизації Terminal-Bench і AutomationBench можуть бути важливішими за загальні показники знань.
Для корпоративної дослідницької команди важливішими можуть бути пошук у довгому контексті та фактологічна точність.
Ключ у тому, щоб обирати бенчмарки, які схожі на ваше реальне навантаження.
GPT-6 проти Claude 5.5: швидкість, контекстне вікно та вартість
Продуктивність — лише одна частина рішення.
Artificial Analysis також наводить такі специфікації та операційні показники для флагманських моделей у Max-режимі.
| Metric | Claude Opus 5.5 | GPT-6 Astra |
|---|---|---|
| Context window | 1M tokens | 1M tokens |
| Input price / 1M tokens | $4 | $10 |
| Output price / 1M tokens | $20 | $50 |
| Output speed | 95 tokens/s | 61 tokens/s |
| Average benchmark task cost | $5.98 | $3.26 |
Джерело: Artificial Analysis — Flagship Model Comparison
Claude Opus 5.5 має нижчі ціни за токен і швидше генерує вихідні дані.
Однак у цій конфігурації GPT-6 Astra має нижчу середню вартість за бенчмарк-завдання.
Чому?
Моделі можуть витрачати різну кількість reasoning- і output-токенів, щоб розв’язати одну й ту саму проблему. Модель із вищою ціною за токен усе одно може коштувати менше за виконане завдання, якщо використовує значно менше токенів.
Для бізнесу це робить вартість за прийняте завдання кориснішою метрикою, ніж ціна токена окремо.
Ці цифри описують середовище оцінювання Artificial Analysis, а не гарантовану затримку чи вартість у продакшені.
GPT-6 Sol проти Claude Sonnet 5.5: щоденна бізнес-робота
Флагманські моделі не завжди потрібні для щоденних операцій.
GPT-6 Sol і Claude Sonnet 5.5 — це релевантні альтернативи для професійного письма, кодування та knowledge work.
Опубліковане порівняння Anthropic показує:
| Benchmark | Claude Sonnet 5.5 | GPT-6 Sol |
|---|---|---|
| FrontierCode 1.1 (Main) | 46.2% (Max) | 49.3% |
| GDPval-AA v2.1 | 1,844 | 1,487 |
| AA-Briefcase v1.1 | 1,811 | 1,483 |
| Input price / 1M tokens | $2 | $2 |
| Output price / 1M tokens | $10 | $10 |
Джерело: Anthropic — Claude Sonnet 5.5 Performance Benchmarks
GPT-6 Sol показує вищий результат у наведеному FrontierCode, тоді як Claude Sonnet 5.5 лідирує в оцінках knowledge work.
Anthropic також повідомляє, що Sonnet 5.5 більш ніж на 30% швидший за Sonnet 5 і коштує до 30% менше для більшості завдань.
Це порівняння, опубліковане Anthropic, і налаштування effort або умови оцінювання можуть відрізнятися між моделями.
Для бізнесу обидві моделі варто протестувати на звітах, презентаціях, розробці ПЗ та інших повторюваних професійних завданнях.
GPT-6 Luna проти Claude Haiku 5.5: AI-завдання у великому обсязі
Менші моделі можуть забезпечувати кращу економіку для повторюваних операцій.
Claude Haiku 5.5 і GPT-6 Luna орієнтовані на чутливі до вартості навантаження, де важливі швидкість і ефективність.
Anthropic наводить такі результати бенчмарків:
| Benchmark | Claude Haiku 5.5 | GPT-6 Luna |
|---|---|---|
| Terminal-Bench 4.0 | 39.2% | 16.4% |
| OSWorld 2.1 (offline subset) | 72.4% | 48.9% |
| FrontierCode 1.1 | 46.4% | 42.4% |
| GDPval-AA v2.1 | 1,620 | 1,437 |
| Input price / 1M tokens | $0.10* | $0.10 |
| Output price / 1M tokens | $0.50* | $0.50 |
Джерело: Anthropic — Claude Haiku 5.5 Benchmarks
Зазначені тарифи Claude Haiku 5.5 діють для запитів до 100,000 токенів; для довших запитів застосовується інше ціноутворення.
У публічних оцінюваннях Anthropic Haiku 5.5 перевершує Luna за всіма наведеними завданнями.
Для бізнесів, що обробляють великі обсяги звернень клієнтів, документів або структурованих даних, ці результати роблять Haiku 5.5 моделлю, яку варто протестувати.
Втім організаціям слід перевірити, чи зберігаються ці переваги на їхніх власних вхідних даних і вимогах до затримки.
GPT-6 проти Claude 5.5 для бізнес-кейсів
Найкраща модель залежить від того, що саме має зробити ваша організація.
Кодування та розробка ПЗ
Обидва сімейства моделей пропонують сильні варіанти для розробки ПЗ.
GPT-6 Astra і Claude Opus 5.5 доречні для складних завдань кодування, тоді як GPT-6.1 Sol і Claude Sonnet 5.5 — це альтернативи для щоденної розробки.
Бізнесу варто оцінювати якість коду на реальних репозиторіях, а не лише за бенчмарками.
Вимірюйте кількість пройдених тестів, час на налагодження, підтримуваність і кількість потрібних правок.
Для AI-агентств з автоматизації ці метрики часто корисніші за швидкість генерації коду як таку.
Дослідження та складний аналіз
Дослідницькі процеси потребують точної інформації, чіткого reasoning і надійної інтерпретації джерел.
Результати Claude Opus 5.5 у просунутому reasoning і бенчмарках довгого контексту роблять його сильним кандидатом для оцінювання.
GPT-6 Astra також має можливості для складних досліджень, аналізу даних і професійних завдань.
У будь-якому випадку організаціям слід перевіряти важливі твердження за надійними джерелами та залучати людину до перевірки там, де рішення мають серйозні наслідки.
Бізнес-документи та knowledge work
Команди часто використовують AI для підготовки звітів, аналізу документів, створення презентацій і підсумовування внутрішньої інформації.
Claude Sonnet 5.5 показує сильні результати в опублікованих бенчмарках knowledge work, тож його варто оцінити для документомістких процесів.
GPT-6 Sol і GPT-6.1 Sol також є релевантними кандидатами для професійної продуктивності.
Найкращий вибір слід робити з огляду на фактологічну точність, якість форматування, обсяг редагування та відповідність вимогам організації.
AI-автоматизація та високонавантажені операції
Командам автоматизації потрібні моделі, які стабільно дають прийнятний результат без зайвих витрат.
Claude Haiku 5.5 і GPT-6 Luna доречні для класифікації, структурованого витягання даних і рутинної обробки.
Однак самі бенчмарки не доводять надійність у продакшені.
Команди також мають оцінити обробку помилок, валідацію результатів, rate limits і вимоги до інтеграції.
Як обрати між GPT-6 і Claude 5.5 для кращого ROI
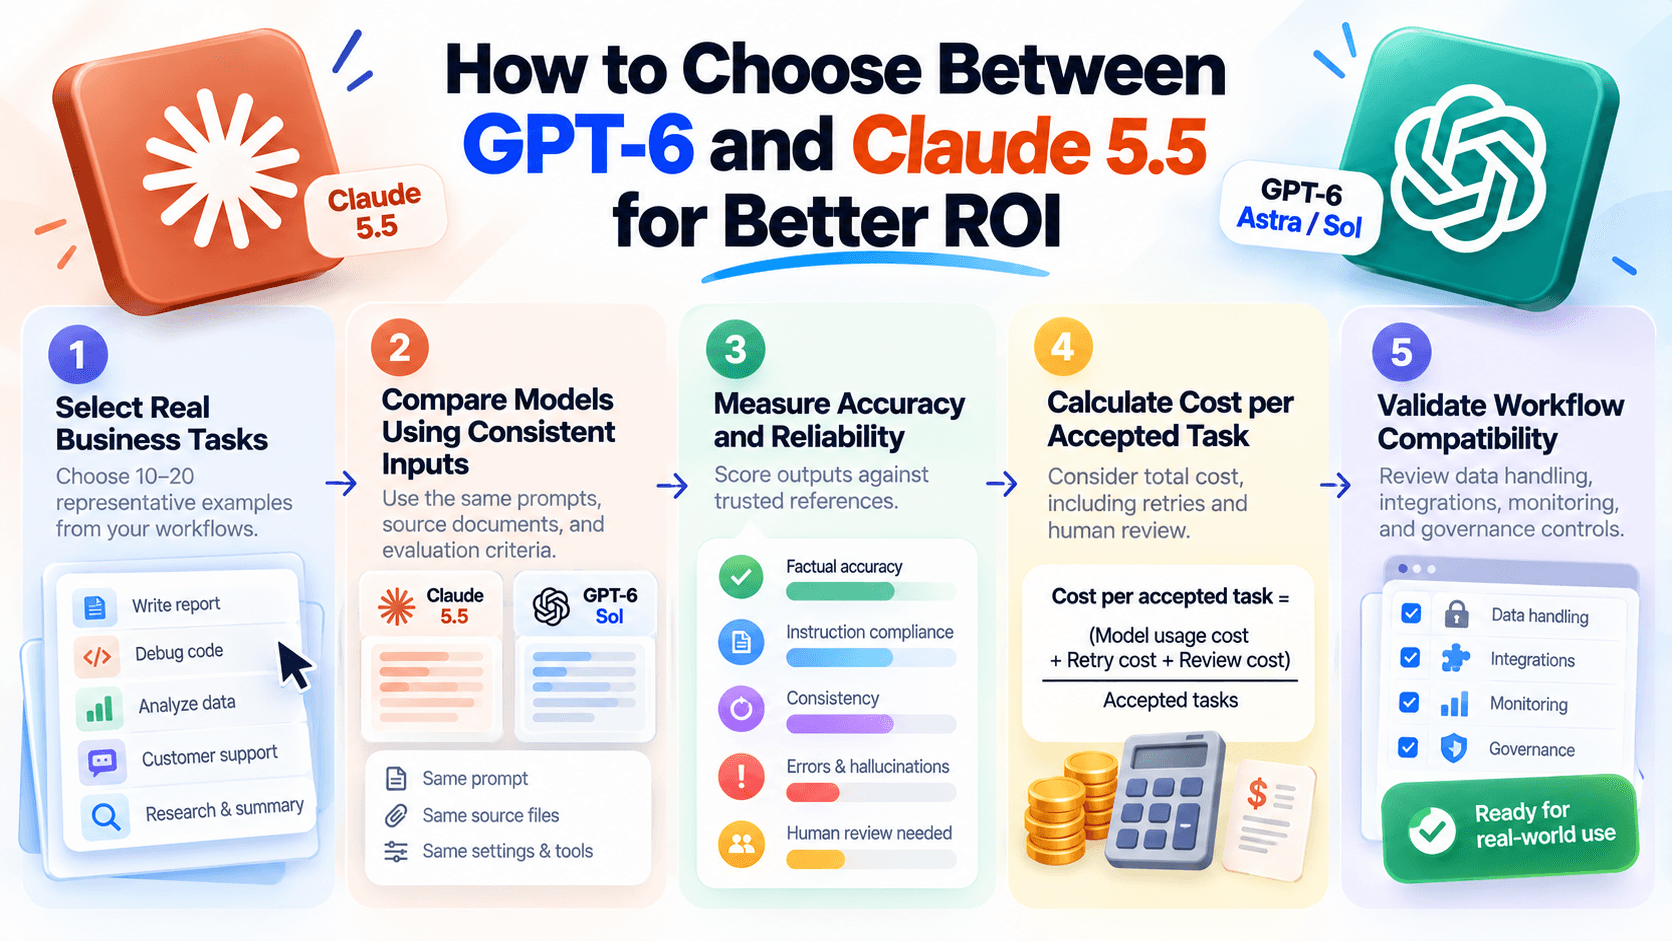
AI-лідери мають оцінювати моделі за вимірюваними бізнес-результатами, а не лише за публічними рейтингами.
Практична схема включає п’ять кроків.
1. Оберіть реальні бізнес-завдання
Візьміть 10–20 репрезентативних прикладів із ваших процесів.
Додайте прості запити, складні завдання та випадки, де ваша поточна модель часто помиляється.
2. Порівнюйте моделі з однаковими вхідними даними
Використовуйте однакові промпти, вихідні документи та критерії оцінювання.
Для чесного порівняння зафіксуйте налаштування reasoning-effort і доступні інструменти для кожної моделі.
3. Вимірюйте точність і надійність
Оцінюйте відповіді за перевіреними джерелами.
Відстежуйте фактологічні помилки, дотримання інструкцій, послідовність і обсяг ручних виправлень.
4. Обчислюйте вартість за прийняте завдання
Замість того щоб зосереджуватися лише на ціні токенів, обчислюйте:
Cost per accepted task = (Model usage cost + Retry cost + Review cost) ÷ Accepted tasks
Це відображає реальні витрати на отримання придатного результату.
5. Перевірте сумісність із робочими процесами
Перед впровадженням моделі перевірте вимоги до обробки даних, інтеграції, моніторинг і механізми управління.
Модель, що добре показує себе в тестах, все одно може вимагати значної інтеграційної роботи, перш ніж стане придатною для продакшену.
Для ширшої схеми вибору прочитайте Best AI Chatbot for Business: How to Compare Options.
Порівнюйте AI-моделі в одному робочому просторі з 1min.AI
Тестування моделей у різних інтерфейсах може ускладнити керування порівняннями.
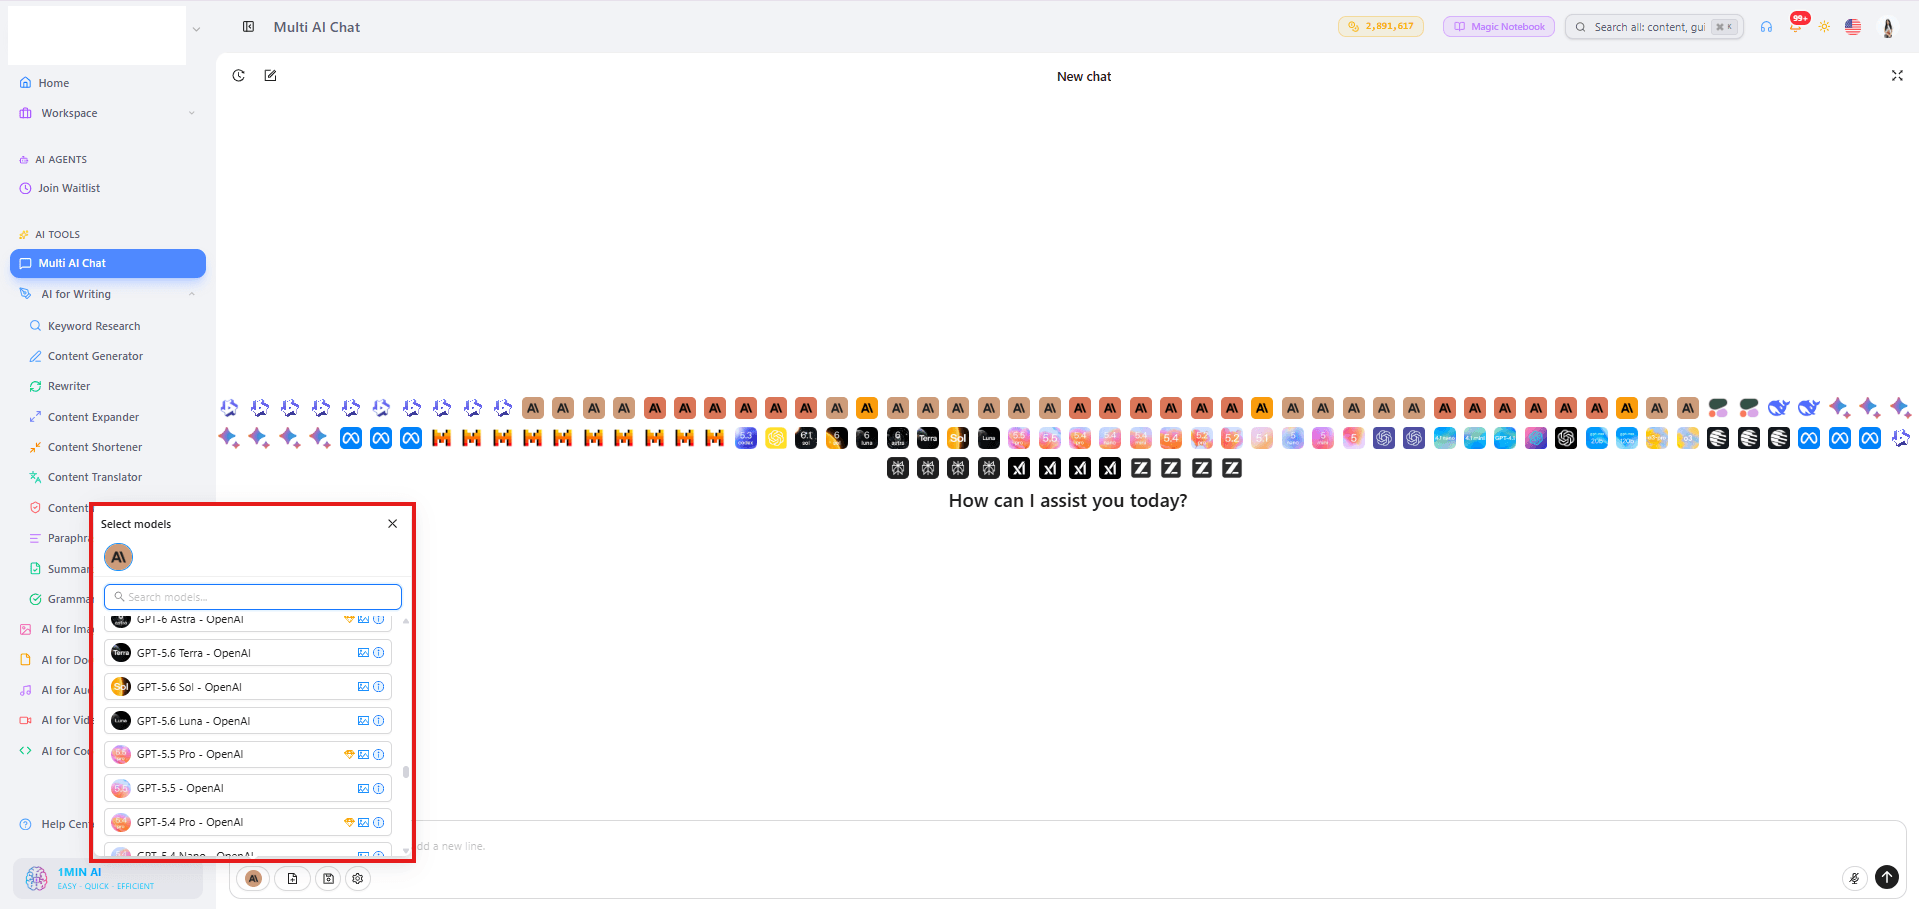
1min.AI надає єдиний робочий простір для доступу до кількох підтримуваних AI-моделей і виконання AI-завдань.
За допомогою Multi AI Chat команди можуть надсилати один і той самий запит до підтримуваних моделей і порівнювати відповіді поруч.
Mix AI Models підтримує роботу з різними моделями в межах однієї розмови, а Document Chat допомагає користувачам взаємодіяти з бізнес-документами.
Для AI Champions та команд інновацій ці функції дають практичну стартову точку для порівняння результатів моделей перед масштабним впровадженням.
Конкретні варіанти GPT-6 і Claude 5.5 слід перевіряти в актуальному списку моделей 1min.AI перед тестуванням.
Робочий простір із кількома моделями може спростити оцінювання, але продакшен-впровадження все одно потребує належних інтеграцій, перевірок безпеки та операційних контролів.
Остаточний висновок: GPT-6 чи Claude 5.5?
Claude Opus 5.5 випереджає GPT-6 Astra за кількома незалежними бенчмарками інтелекту та кодування. Claude Sonnet 5.5 і Haiku 5.5 також демонструють сильні результати в опублікованих Anthropic порівняннях для професійної роботи та малих моделей.
Водночас моделі GPT-6 залишаються конкурентними, а GPT-6 Astra показує, що вищі ціни за токен можуть поєднуватися з нижчою вартістю бенчмарк-завдань.
Для бізнесу універсального переможця немає.
Обирайте модель, яка забезпечує потрібні точність, надійність і сумісність із робочими процесами за найнижчою сталою загальною вартістю.
Замість того щоб змінювати постачальника через черговий реліз, тестуйте кілька моделей на реальних робочих навантаженнях і вимірюйте результати.
Дослідити 1min.AI щоб порівнювати підтримувані AI-моделі в одному робочому просторі та знайти найкращий варіант для вашого бізнесу.
Поширені запитання
Чи GPT-6 кращий за Claude 5.5?
Не за всіма бенчмарками. Claude Opus 5.5 лідирує в кількох незалежних оцінках інтелекту та кодування, тоді як GPT-6 Astra краще працює в окремих тестах і може мати нижчу вартість за бенчмарк-завдання.
Що краще для кодування: GPT-6 чи Claude 5.5?
Обидва пропонують конкурентні моделі для кодування. Claude Opus 5.5 показує сильні результати в Terminal-Bench 4.0, тоді як GPT-6 Sol випереджає Claude Sonnet 5.5 у наведеному порівнянні FrontierCode. Результати залежать від рівня моделі, налаштування effort і самого завдання з кодування.
Що дешевше: GPT-6 чи Claude 5.5?
Це залежить від моделі та навантаження. Claude Opus 5.5 має нижчі заявлені ціни за токен, ніж GPT-6 Astra, але остання може використовувати менше токенів на завдання. Порівнюйте загальні витрати за прийняте завдання, а не лише ціну токенів.
Чи Claude 5.5 кращий для бізнес-документів?
Claude Sonnet 5.5 показує сильні результати в опублікованих бенчмарках knowledge work. Втім бізнесу слід порівняти його з моделями GPT-6 на власних документах і за власними стандартами оцінювання.
Чи можу я порівняти GPT-6 і Claude 5.5 через 1min.AI?
1min.AI підтримує порівняння відповідей від кількох доступних AI-моделей через Multi AI Chat. Перевірте актуальний список моделей платформи, щоб підтвердити наявність конкретних варіантів GPT-6 і Claude 5.5, які ви хочете оцінити.
- #Informational
Альтернативи
Відкрийте для себе найкращі альтернативи 1minAI та порівняйте функції, ціни та варіанти використання.
1min.AI vs OpenRouter
1min.AI vs. OpenRouter: Порівняйте готовий до використання продукт для створення з AI з технічним API-інструментом. Дізнайтеся, чи потрібна вам креативна студія без коду або інфраструктурний хаб для програмування.
 Ngoc Hong
1min. AI vs Dola AI
Шукаєте альтернативу Dola AI? Порівняйте 1min.AI та Dola AI за генерацією відео, безкоштовними планами, цінами та приватністю, щоб обрати правильний AI-додаток.
Ngoc Hong
1minAI vs Hix AI
Порівняйте 5 альтернатив HIX AI для AI-чату, досліджень, письма, зображень, відео, цін і гнучких AI-робочих процесів.
Ngoc HongІнструменти ШІ
Відкрийте для себе найкращі інструменти ШІ для підвищення продуктивності, креативності та повсякденної роботи.
Створюйте послідовний мультяшний контент лише за кілька кроків
Створюйте мультяшні відео для TikTok і Reels у 3 простих кроки з 1min.AI — від пошуку ідей до персонажів і анімованих відео.
 Lien Anh Vu
Один продукт, 10 UGC-креативів: як ШІ спрощує тестування контенту
Створюйте більш автентичний UGC за допомогою AI UGC video generator, тестуйте більше креативних кутів і масштабуйте affiliate-контент без зйомки кожної версії.
Lien Anh Vu
Топ-4 доступні AI-інструменти для засновників стартапів
Дізнайтеся про топ-4 доступні AI-інструменти для засновників стартапів, щоб перевіряти ідеї, створювати продукти, готувати контент і запускатися швидше без зайвих витрат.
 Tram Ta
Можливості ШІ
Комплексні можливості ШІ, що спрощують робочі процеси, підвищують ефективність і допомагають командам досягати більшого.
Створюйте послідовний мультяшний контент лише за кілька кроків
Створюйте мультяшні відео для TikTok і Reels у 3 простих кроки з 1min.AI — від пошуку ідей до персонажів і анімованих відео.
Lien Anh VuОдин продукт, 10 UGC-креативів: як ШІ спрощує тестування контенту
Створюйте більш автентичний UGC за допомогою AI UGC video generator, тестуйте більше креативних кутів і масштабуйте affiliate-контент без зйомки кожної версії.
Lien Anh Vu
1minAI: Безкоштовний AI-перевірник граматики
Перевіряйте граматику безкоштовно за допомогою AI-перевірника граматики 1minAI. Знаходьте граматичні, орфографічні та стилістичні помилки, покращуйте чіткість і вдосконалюйте свій текст за секунди.
Tram TaВипадки застосування ШІ
Добірка прикладів застосування ШІ для бізнесу, підвищення продуктивності та галузевих рішень.
Створюйте послідовний мультяшний контент лише за кілька кроків
Створюйте мультяшні відео для TikTok і Reels у 3 простих кроки з 1min.AI — від пошуку ідей до персонажів і анімованих відео.
Lien Anh VuОдин продукт, 10 UGC-креативів: як ШІ спрощує тестування контенту
Створюйте більш автентичний UGC за допомогою AI UGC video generator, тестуйте більше креативних кутів і масштабуйте affiliate-контент без зйомки кожної версії.
Lien Anh Vu
Найкращий час для публікації в Instagram: практичний посібник для кращої залученості
Дізнайтеся найкращий час для публікації в Instagram, зокрема найкращі дні та години для різних аудиторій, а також поради, як знайти ідеальний графік публікацій для свого акаунта.
Tram TaУроки зі ШІ
Дізнайтеся, як використовувати ШІ за допомогою практичних покрокових уроків.
Створюйте послідовний мультяшний контент лише за кілька кроків
Створюйте мультяшні відео для TikTok і Reels у 3 простих кроки з 1min.AI — від пошуку ідей до персонажів і анімованих відео.
Lien Anh Vu
Пропозиції на AI-інструменти в Чорну п’ятницю 2026
Дізнайтеся, що пропонує Чорна п’ятниця 2026 для AI-інструментів. Дізнайтеся, як отримати lifetime deal на 1min.AI через AppSumo, Dealify, Stack Social і перевірити його на Trustpilot, Slashdot та Software Advice.
 Hang Nguyen
Сумісність AI image to video з Seedance для продуктів, щоб зупинити спотворення й масштабувати огляди товарів
Зупиняйте спотворення логотипів за допомогою AI image to video product consistency та створюйте оглядові відео студійного рівня на 1min.AI вже сьогодні.
Lien Anh VuПосібники зі штучного інтелекту
Вивчайте ШІ швидше за допомогою практичних посібників, реальних прикладів і дієвих найкращих практик.
Створюйте послідовний мультяшний контент лише за кілька кроків
Створюйте мультяшні відео для TikTok і Reels у 3 простих кроки з 1min.AI — від пошуку ідей до персонажів і анімованих відео.
Lien Anh Vu
Безпечно купуйте AI-інструменти онлайн: путівник до Black Friday 2026
Дізнайтеся, як знаходити та безпечно купувати найкращі AI-пропозиції Black Friday онлайн. Опануйте експертні стратегії, щоб уникати шахрайства, боротися з втомою від підписок і перевіряти софт.
Hang NguyenСумісність AI image to video з Seedance для продуктів, щоб зупинити спотворення й масштабувати огляди товарів
Зупиняйте спотворення логотипів за допомогою AI image to video product consistency та створюйте оглядові відео студійного рівня на 1min.AI вже сьогодні.
Lien Anh VuРішення зі ШІ
Перегляньте найкращі рішення зі ШІ для автоматизації, кодування, досліджень, продуктивності, підтримки клієнтів, маркетингу та бізнес-процесів.
Створюйте послідовний мультяшний контент лише за кілька кроків
Створюйте мультяшні відео для TikTok і Reels у 3 простих кроки з 1min.AI — від пошуку ідей до персонажів і анімованих відео.
Lien Anh VuОдин продукт, 10 UGC-креативів: як ШІ спрощує тестування контенту
Створюйте більш автентичний UGC за допомогою AI UGC video generator, тестуйте більше креативних кутів і масштабуйте affiliate-контент без зйомки кожної версії.
Lien Anh Vu
Безкоштовний AI-генератор татуювань: індивідуальні дизайни
Перетворіть будь-яку ідею на індивідуальний дизайн татуювання з безкоштовним AI-генератором татуювань 1min.AI. Опишіть свою ідею, оберіть стиль і завантажте за секунди.
 Trang Tran
Моделі ШІ
Дослідіть провідні світові моделі ШІ в одному місці.
Створюйте послідовний мультяшний контент лише за кілька кроків
Створюйте мультяшні відео для TikTok і Reels у 3 простих кроки з 1min.AI — від пошуку ідей до персонажів і анімованих відео.
Lien Anh VuОдин продукт, 10 UGC-креативів: як ШІ спрощує тестування контенту
Створюйте більш автентичний UGC за допомогою AI UGC video generator, тестуйте більше креативних кутів і масштабуйте affiliate-контент без зйомки кожної версії.
Lien Anh VuСумісність AI image to video з Seedance для продуктів, щоб зупинити спотворення й масштабувати огляди товарів
Зупиняйте спотворення логотипів за допомогою AI image to video product consistency та створюйте оглядові відео студійного рівня на 1min.AI вже сьогодні.
Lien Anh VuПорівняння ШІ
Порівняйте інструменти, моделі та платформи ШІ, щоб знайти найкращий варіант для ваших потреб.
Kling AI vs Veo 3: Яка модель перемагає?
Kling AI vs Veo 3: порівняйте рух, нативне аудіо, ціни та безплатні тарифи, щоб зрозуміти, який AI-генератор відео краще підходить для вашого проєкту — спробуйте обидва на 1min.AI.
Trang TranСумісність AI image to video з Seedance для продуктів, щоб зупинити спотворення й масштабувати огляди товарів
Зупиняйте спотворення логотипів за допомогою AI image to video product consistency та створюйте оглядові відео студійного рівня на 1min.AI вже сьогодні.
Lien Anh Vu
Порівняння DeepSeek V4 Pro та Flash
Порівняйте метрики DeepSeek V4 Pro та DeepSeek V4 Flash. Оптимізуйте свої agentic-додатки та покращуйте фактчекінг ШІ на 1min.ai вже сьогодні.
Ngoc HongІнтеграції ШІ
Безшовно інтегруйте ШІ з інструментами, якими ви вже користуєтеся, щоб автоматизувати роботу та підвищити продуктивність.
Як використовувати AI-генератор fashion-відео для Fashion Week 2026
Перетворюйте ідеї Fashion Week 2026 на вражаючі fashion-відео за допомогою AI. Дізнайтеся, як генерувати ідеї, створювати візуали та перетворювати зображення на відео за допомогою одного простого робочого процесу.
Lien Anh Vu
POV: У тебе щодня понад 10 постів для створення
Дізнайтеся, як побудувати AI-робочий процес для контенту, який допомагає креаторам швидше створювати 10+ публікацій на день за допомогою AI-брейнштормінгу, генерації зображень і створення контенту.
Lien Anh Vu
Припиніть перемикатися між AI-додатками: як AI-інтеграція трансформує employer branding
Дізнайтеся, як AI-інтеграція допомагає HR-командам спростити employer branding, поєднуючи AI-генерацію текстів, документи, зображення, відео та кілька AI-моделей в одному робочому просторі.
Tram TaШІ для промисловості
Знайдіть найкращі інструменти та робочі процеси ШІ для охорони здоров'я, фінансів, освіти, юриспруденції, виробництва, роздрібної торгівлі, нерухомості та багато іншого.
Безкоштовний генератор описів продуктів на основі AI
Пишіть описи товарів, які продають, за хвилини. Використайте цей безкоштовний AI-генератор описів продуктів, щоб перетворити деталі або фото на фірмовий текст. Спробуйте 1min.AI.
Trang Tran
Найкращі інструменти для бізнес-продуктивності для стартапів, щоб максимізувати прибуток | 1minAI
Дізнайтеся про найкращі інструменти для бізнес-продуктивності для стартапів, щоб заощаджувати час, оптимізувати робочі процеси, зменшувати рутинні завдання та підтримувати прибуткове зростання за допомогою ШІ.
Tram Ta
Найкращий AI-інструмент для контент-маркетингу |1minAI
Шукаєте найкращий AI-інструмент для контент-маркетингу? Дізнайтеся, як 1minAI допомагає маркетологам досліджувати, писати, адаптувати, створювати візуали та масштабувати контент з однієї AI-робочої області.
Tram TaАгенти ШІ
Відкрийте та використовуйте агентів ШІ для автоматизації завдань у вашій роботі та повсякденному житті.
1minAI: Безкоштовний AI-перевірник граматики
Перевіряйте граматику безкоштовно за допомогою AI-перевірника граматики 1minAI. Знаходьте граматичні, орфографічні та стилістичні помилки, покращуйте чіткість і вдосконалюйте свій текст за секунди.
Tram Ta
AI-агенти для Facebook
Використовуйте AI-агента для Facebook, щоб створювати контент, генерувати зображення, планувати публікації та публікувати їх із ваших документів і розмов.
Ngoc Hong
AI Agent vs AI Assistant: Що насправді економить дизайнерам більше часу?
Дізнайтеся різницю між AI Agent та AI Assistant і відкрийте для себе, яке рішення допомагає дизайнерам автоматизувати рутинну роботу, зменшити кількість правок і заощадити більше часу.
Lien Anh VuРобочі процеси ШІ
Ознайомтеся з готовими робочими процесами ШІ для підвищення продуктивності, маркетингу, продажів, підтримки та іншого.
Створюйте послідовний мультяшний контент лише за кілька кроків
Створюйте мультяшні відео для TikTok і Reels у 3 простих кроки з 1min.AI — від пошуку ідей до персонажів і анімованих відео.
Lien Anh VuОдин продукт, 10 UGC-креативів: як ШІ спрощує тестування контенту
Створюйте більш автентичний UGC за допомогою AI UGC video generator, тестуйте більше креативних кутів і масштабуйте affiliate-контент без зйомки кожної версії.
Lien Anh VuЯк використовувати AI-генератор fashion-відео для Fashion Week 2026
Перетворюйте ідеї Fashion Week 2026 на вражаючі fashion-відео за допомогою AI. Дізнайтеся, як генерувати ідеї, створювати візуали та перетворювати зображення на відео за допомогою одного простого робочого процесу.
Lien Anh VuРозсилка
Щотижневі інновації в галузі ШІ від 1minAI
🔮 Щотижневі інновації в AI #142: Grok 4.7, Opus 5.5 і Sonnet 5.5 на 1min.ai
Отримайте доступ до Grok 4.7, Claude Opus 5.5 та Sonnet 5.5 на 1min.ai. Скоротіть витрати на підписки до 70% і обробляйте мільйони токенів в єдиному робочому просторі.
Hang Nguyen
🔮 Щотижневі інновації AI #143: Оновлення Update GPT-6, GPT-6.1 & Ideogram 4.0 & Ideogram 4.0
Отримайте доступ до GPT-6 Sol, Luna, GPT-6.1 Sol і Ideogram 4.0 на 1min.ai. Підвищте точність типографіки до 98,4% і скоротіть затримку міркування на 45% в одній платформі.
Hang Nguyen
🔮 Щотижневі інновації ШІ #141: Seedance 2.5 і Stable Audio 3: ШІ нового покоління
Досліджуйте Seedance 2.0, 2.5 та Stable Audio 3 від StabilityAI на 1min.ai. Створюйте аудіо студійного рівня та синхронізований рух за допомогою генеративного ШІ нового покоління.
Hang Nguyen