
GPT-6 vs Claude 5.5: Care este mai bun pentru afaceri?

Ngoc Hong
16 octombrie 2026
Compară GPT-6 și Claude 5.5 pentru programare, cercetare și fluxuri de lucru de business. Descoperă ce model AI se potrivește nevoilor, bugetului și obiectivelor de productivitate ale echipei tale.
GPT-6 vs Claude 5.5: Care este mai bun pentru afaceri?
GPT-6 vs Claude 5.5 este o comparație importantă pentru companiile care decid ce modele AI să adopte. Atât OpenAI, cât și Anthropic oferă modele puternice pentru programare, cercetare, analiza documentelor și sarcini profesionale complexe. Dar scorurile mai bune în benchmark-uri nu se traduc întotdeauna în rezultate mai bune pentru business.
Pentru liderii AI, echipele de inovație și agențiile de automatizare, decizia ar trebui să țină cont de performanță, fiabilitate, cost și compatibilitatea cu fluxul de lucru.
Acest ghid compară GPT-6 și Claude 5.5 folosind benchmark-uri publicate, specificații oficiale ale modelelor și cazuri practice de utilizare în business.
GPT-6 vs Claude 5.5: Diferențe cheie pe scurt
GPT-6 și Claude 5.5 sunt familii de modele, nu modele individuale. Fiecare include opțiuni pentru diferite niveluri de complexitate și cost.
| Category | GPT-6 family | Claude 5.5 family |
|---|---|---|
| Developer | OpenAI | Anthropic |
| Flagship model | GPT-6 Astra | Claude Opus 5.5 |
| Professional work | GPT-6.1 Sol | Claude Sonnet 5.5 |
| Cost-efficient model | GPT-6 Luna | Claude Haiku 5.5 |
| Key strengths to evaluate | Advanced reasoning, coding, computer use | Complex analysis, coding, knowledge work |
| Main business consideration | Capability versus task cost | Quality, efficiency, and workload fit |
OpenAI poziționează Astra pentru cele mai solicitante sarcini, iar GPT-6.1 Sol pentru capabilități apropiate de modelul flagship la un preț mai mic. Anthropic poziționează Opus pentru judecată complexă, Sonnet pentru munca profesională de zi cu zi și Haiku pentru operațiuni de volum mare.
Verdict rapid: Claude Opus 5.5 îl depășește pe GPT-6 Astra în mai multe benchmark-uri independente de inteligență și programare. Totuși, GPT-6 Astra poate finaliza anumite sarcini de benchmark cu mai puțini tokeni și cost total mai mic per sarcină.
Cea mai bună alegere pentru business depinde de compromisurile care contează cel mai mult.
Sources: OpenAI GPT-6 Model Guide | Anthropic Claude Sonnet 5.5
GPT-6 vs Claude 5.5 Benchmarks: Care performează mai bine?
Benchmark-urile independente ajută companiile să evalueze capabilitățile modelelor dincolo de afirmațiile de marketing.
Artificial Analysis compară Claude Opus 5.5 și GPT-6 Astra în privința raționamentului, programării, automatizării, costului și vitezei.
GPT-6 Astra vs Claude Opus 5.5: Benchmark-uri independente
Rezultatele de mai jos compară ambele modele la configurațiile lor de Max reasoning-effort.
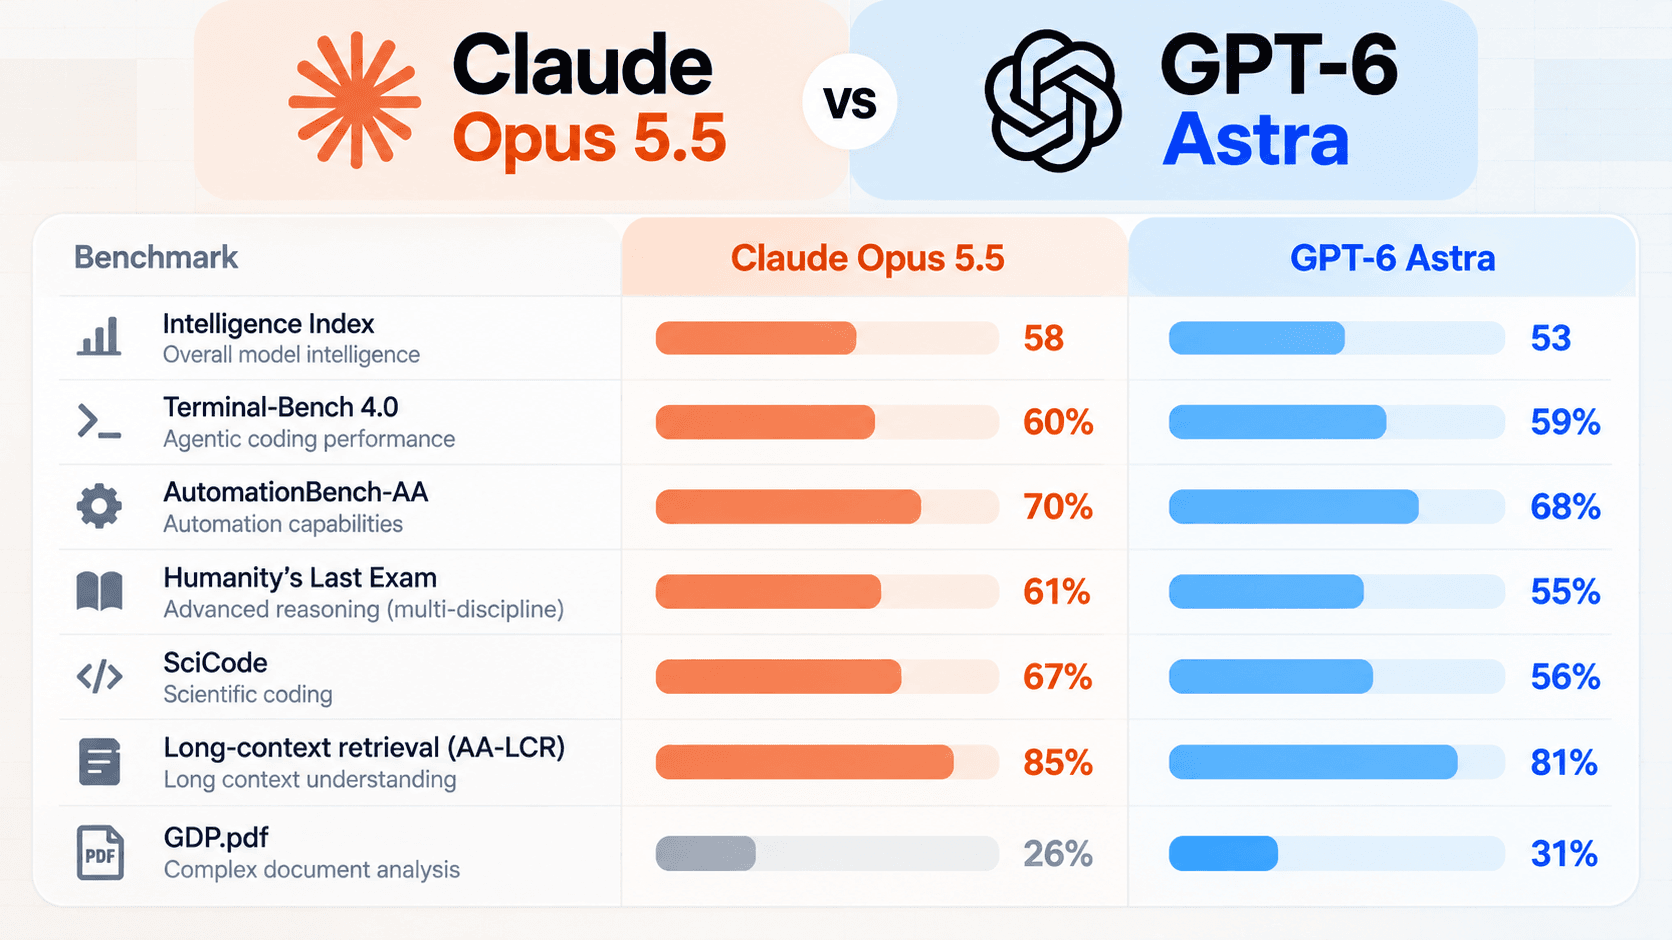
Sursa: Artificial Analysis — Claude Opus 5.5 vs GPT-6 Astra (Max)
Claude Opus 5.5 conduce la inteligență generală, programare științifică și mai multe evaluări avansate de raționament.
GPT-6 Astra performează mai bine pe GDP.pdf, ceea ce arată că rezultatele nu sunt în mod uniform în favoarea lui Claude.
Aceste scoruri reflectă și configurații specifice de testare. O setare diferită a efortului de raționament poate schimba atât performanța, cât și costul.
Ce înseamnă aceste benchmark-uri pentru business?
Benchmark-urile diferite măsoară capabilități diferite.
- Terminal-Bench 4.0: Evaluează capacitatea unui agent AI de a finaliza sarcini folosind instrumente bazate pe terminal.
- AutomationBench-AA: Măsoară performanța pe sarcini orientate spre automatizare.
- Humanity's Last Exam: Testează cunoștințe avansate și raționament din mai multe domenii.
- SciCode: Evaluează capabilitățile de programare științifică.
- AA-LCR: Măsoară acuratețea recuperării informațiilor pe contexte lungi.
Pentru o agenție de automatizare, Terminal-Bench și AutomationBench pot fi mai relevante decât scorurile generale de cunoștințe.
Pentru o echipă de cercetare din enterprise, recuperarea pe contexte lungi și acuratețea factuală pot conta mai mult.
Ideea cheie este să alegi benchmark-uri care seamănă cu volumul tău real de muncă.
GPT-6 vs Claude 5.5: Viteză, fereastră de context și cost
Performanța este doar o parte a deciziei.
Artificial Analysis raportează și următoarele specificații și măsurători operaționale pentru modelele flagship la efort Max.
| Metric | Claude Opus 5.5 | GPT-6 Astra |
|---|---|---|
| Context window | 1M tokens | 1M tokens |
| Input price / 1M tokens | $4 | $10 |
| Output price / 1M tokens | $20 | $50 |
| Output speed | 95 tokens/s | 61 tokens/s |
| Average benchmark task cost | $5.98 | $3.26 |
Sursa: Artificial Analysis — Flagship Model Comparison
Claude Opus 5.5 are prețuri mai mici per token și o generare a outputului măsurată mai rapidă.
Totuși, GPT-6 Astra are un cost mediu mai mic per sarcină de benchmark în această configurație.
De ce?
Modelele pot consuma numere diferite de tokeni de raționament și output pentru a rezolva aceeași problemă. Un model cu prețuri mai mari per token poate costa totuși mai puțin per sarcină finalizată dacă folosește semnificativ mai puțini tokeni.
Pentru companii, acest lucru face costul per sarcină acceptată mai util decât prețul per token luat separat.
Aceste cifre descriu mediul de evaluare Artificial Analysis, nu latența sau costul garantat în producție.
GPT-6 Sol vs Claude Sonnet 5.5: Munca de business de zi cu zi
Modelele flagship nu sunt întotdeauna necesare pentru operațiunile zilnice.
GPT-6 Sol și Claude Sonnet 5.5 sunt alternative relevante pentru redactare profesională, programare și activități de knowledge work.
Comparația publicată de Anthropic raportează:
| Benchmark | Claude Sonnet 5.5 | GPT-6 Sol |
|---|---|---|
| FrontierCode 1.1 (Main) | 46.2% (Max) | 49.3% |
| GDPval-AA v2.1 | 1,844 | 1,487 |
| AA-Briefcase v1.1 | 1,811 | 1,483 |
| Input price / 1M tokens | $2 | $2 |
| Output price / 1M tokens | $10 | $10 |
Sursa: Anthropic — Claude Sonnet 5.5 Performance Benchmarks
GPT-6 Sol obține un scor mai mare în rezultatul FrontierCode listat, în timp ce Claude Sonnet 5.5 conduce în evaluările de knowledge work.
Anthropic raportează, de asemenea, că Sonnet 5.5 este cu peste 30% mai rapid decât Sonnet 5 și costă cu până la 30% mai puțin pentru majoritatea sarcinilor.
Acestea sunt comparații publicate de Anthropic, iar setările de efort sau condițiile de evaluare pot diferi între modele.
Pentru companii, merită testate ambele modele pe rapoarte, prezentări, dezvoltare software și alte sarcini profesionale recurente.
GPT-6 Luna vs Claude Haiku 5.5: Sarcini AI de volum mare
Modelele mai mici pot oferi o economie mai bună pentru operațiuni repetitive.
Claude Haiku 5.5 și GPT-6 Luna se adresează sarcinilor sensibile la cost, unde contează viteza și eficiența.
Anthropic raportează următoarele rezultate de benchmark:
| Benchmark | Claude Haiku 5.5 | GPT-6 Luna |
|---|---|---|
| Terminal-Bench 4.0 | 39.2% | 16.4% |
| OSWorld 2.1 (offline subset) | 72.4% | 48.9% |
| FrontierCode 1.1 | 46.4% | 42.4% |
| GDPval-AA v2.1 | 1,620 | 1,437 |
| Input price / 1M tokens | $0.10* | $0.10 |
| Output price / 1M tokens | $0.50* | $0.50 |
Sursa: Anthropic — Claude Haiku 5.5 Benchmarks
Tarifele listate pentru Claude Haiku 5.5 se aplică prompturilor de până la 100.000 de tokeni; prompturile mai lungi au prețuri diferite.
În evaluările publicate de Anthropic, Haiku 5.5 depășește Luna în sarcinile listate.
Pentru companiile care procesează volume mari de cereri de la clienți, documente sau date structurate, aceste rezultate fac ca Haiku 5.5 să merite testat.
Totuși, organizațiile ar trebui să verifice dacă aceste avantaje se mențin pentru propriile intrări și cerințe de latență.
GPT-6 vs Claude 5.5 pentru cazuri de utilizare în business
Cel mai bun model depinde de ceea ce trebuie să realizeze organizația ta.
Programare și dezvoltare software
Ambele familii de modele oferă candidați puternici pentru dezvoltare software.
GPT-6 Astra și Claude Opus 5.5 sunt relevante pentru sarcini complexe de programare, în timp ce GPT-6.1 Sol și Claude Sonnet 5.5 oferă alternative pentru munca de dezvoltare de zi cu zi.
Companiile ar trebui să evalueze calitatea codului folosind depozite reale, nu doar scoruri de benchmark.
Măsoară testele trecute, timpul de depanare, mentenabilitatea și numărul de revizuiri necesare.
Pentru agențiile de automatizare AI, aceste metrici sunt adesea mai utile decât viteza brută de generare a codului.
Cercetare și analiză complexă
Fluxurile de lucru pentru cercetare necesită informații exacte, raționament clar și interpretare fiabilă a materialelor-sursă.
Rezultatele lui Claude Opus 5.5 la benchmark-uri de raționament avansat și contexte lungi îl fac un candidat puternic pentru evaluare.
GPT-6 Astra oferă, de asemenea, capabilități pentru cercetare complexă, analiză de date și sarcini profesionale.
Pentru oricare dintre modele, organizațiile ar trebui să verifice afirmațiile importante în surse de încredere și să includă revizie umană atunci când deciziile au consecințe semnificative.
Documente de business și knowledge work
Echipele folosesc frecvent AI pentru a redacta rapoarte, a analiza documente, a pregăti prezentări și a rezuma informații interne.
Claude Sonnet 5.5 performează puternic în benchmark-urile publicate pentru knowledge work, ceea ce îl face demn de evaluat pentru operațiuni cu multe documente.
GPT-6 Sol și GPT-6.1 Sol sunt, de asemenea, candidați relevanți pentru productivitate profesională.
Cea mai bună alegere ar trebui să se bazeze pe acuratețea factuală, calitatea formatării, efortul de editare și consistența cu cerințele organizației.
Automatizare AI și operațiuni de volum mare
Echipele de automatizare au nevoie de modele care livrează rezultate acceptabile în mod repetat, fără costuri inutile.
Claude Haiku 5.5 și GPT-6 Luna sunt relevante pentru clasificare, extracție structurată și procesare de rutină.
Totuși, scorurile de benchmark singure nu stabilesc fiabilitatea în producție.
Echipele ar trebui să evalueze și gestionarea erorilor, validarea outputului, limitele de rată și cerințele de integrare.
Cum alegi între GPT-6 și Claude 5.5 pentru un ROI mai bun
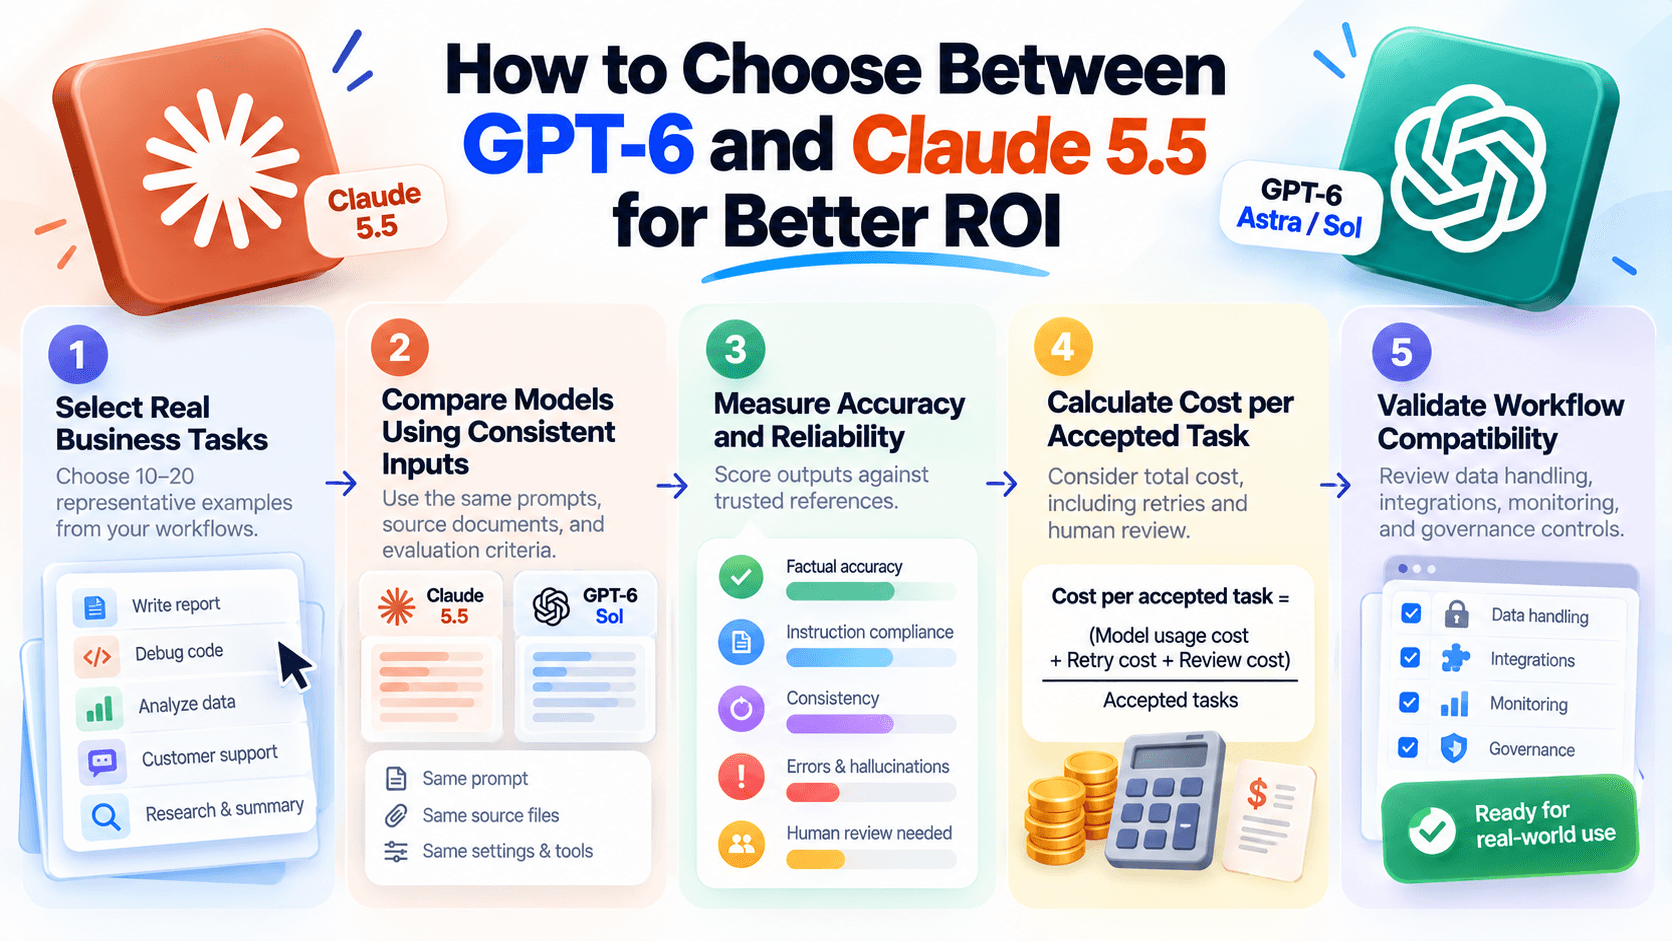
Liderii AI ar trebui să evalueze modelele în funcție de rezultate de business măsurabile, nu doar de clasamente publice.
Un cadru practic include cinci pași.
1. Selectează sarcini reale de business
Alege 10–20 de exemple reprezentative din fluxurile tale de lucru.
Include cereri simple, sarcini complexe și cazuri în care modelul actual eșuează frecvent.
2. Compară modelele folosind inputuri consecvente
Folosește prompturi echivalente, documente-sursă și criterii de evaluare identice.
Pentru o comparație corectă, documentează setările de efort de raționament și instrumentele disponibile fiecărui model.
3. Măsoară acuratețea și fiabilitatea
Evaluează outputurile în raport cu referințe de încredere.
Urmărește erorile factuale, respectarea instrucțiunilor, consistența și cantitatea de corecturi umane necesare.
4. Calculează costul per sarcină acceptată
În loc să te concentrezi doar pe prețul per token, calculează:
Cost per sarcină acceptată = (costul de utilizare al modelului + costul retry-ului + costul revizuirii) ÷ sarcini acceptate
Acest lucru surprinde costul real al producerii unor rezultate utilizabile.
5. Validează compatibilitatea cu fluxul de lucru
Înainte de a implementa un model, verifică cerințele de gestionare a datelor, integrările, monitorizarea și controalele de guvernanță.
Un model care performează bine în testare poate necesita totuși un efort semnificativ de integrare înainte de a fi potrivit pentru producție.
Pentru un cadru mai larg de selecție, citește Cel mai bun chatbot AI pentru business: cum să compari opțiunile.
Compară modele AI într-un singur workspace cu 1min.AI
Testarea modelelor în interfețe separate poate face comparațiile mai greu de gestionat.
1min.AI oferă un workspace unificat pentru accesarea mai multor modele AI suportate și pentru finalizarea sarcinilor asistate de AI.
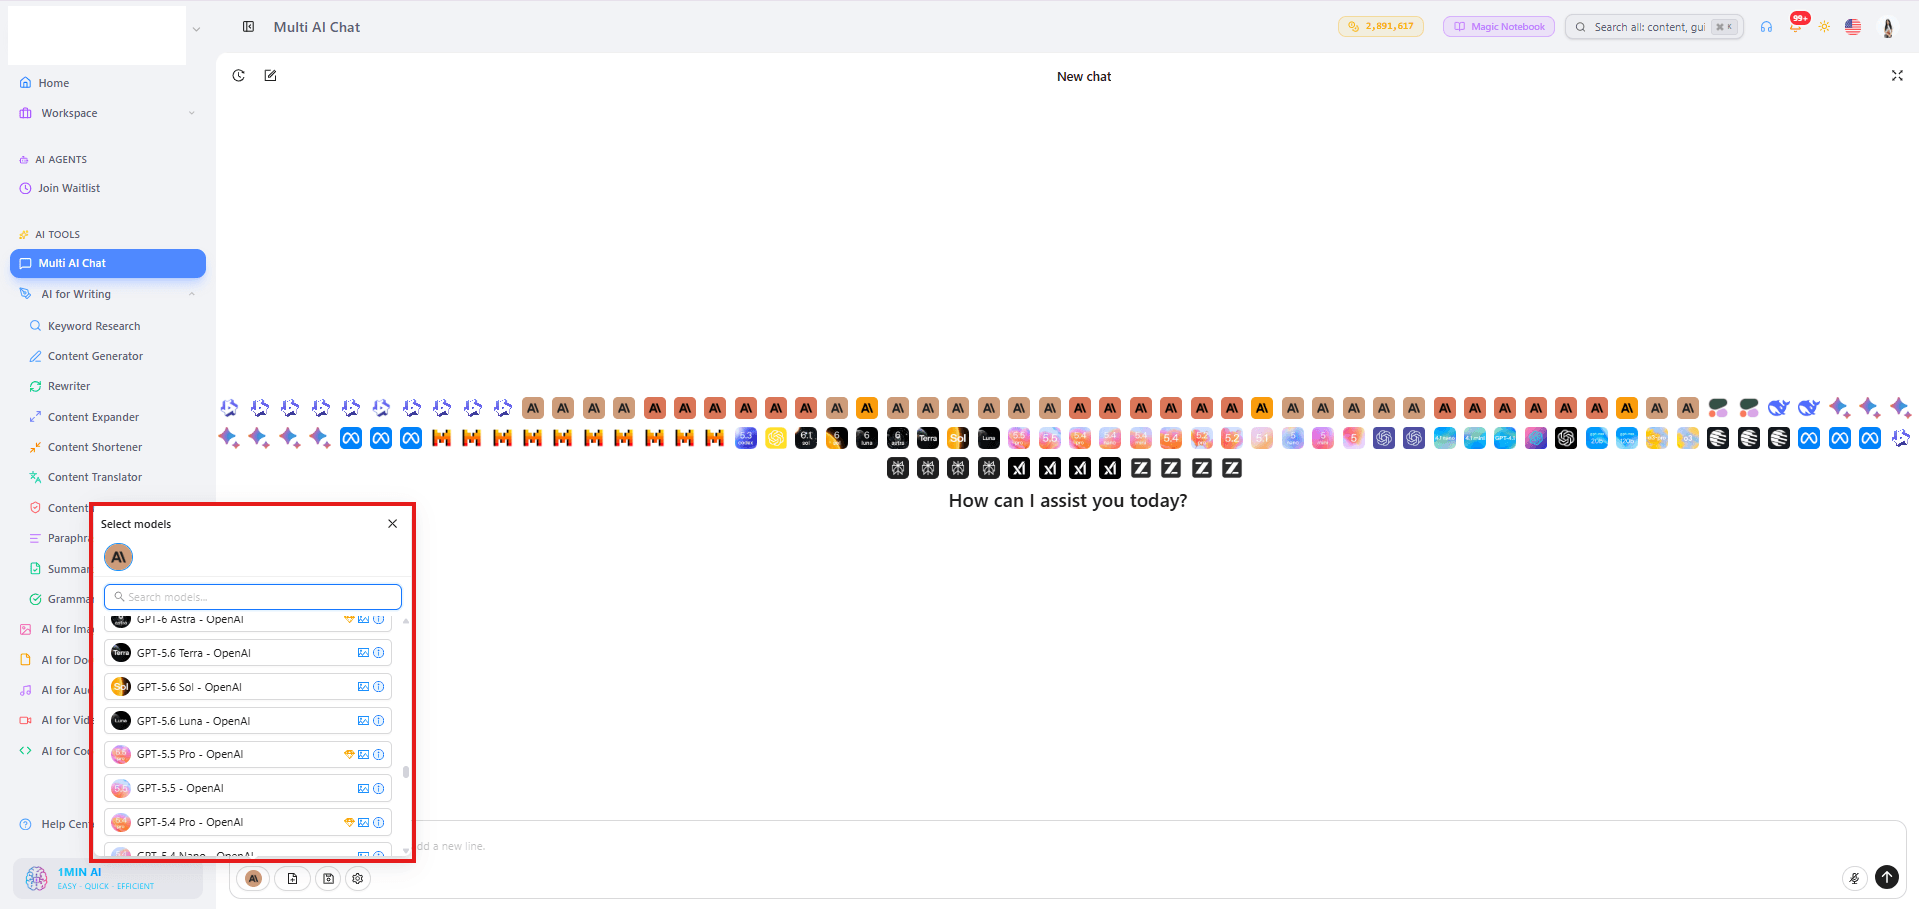
Cu Multi AI Chat, echipele pot trimite același prompt către modelele suportate și pot compara răspunsurile alăturat.
Mix AI Models permite lucrul cu modele diferite într-o conversație, iar Document Chat ajută utilizatorii să interacționeze cu documente de business.
Pentru AI Champions și echipele de inovație, aceste funcții oferă un punct de plecare practic pentru compararea outputurilor modelelor înainte de a trece la o implementare mai amplă.
Variantele specifice GPT-6 și Claude 5.5 ar trebui verificate în selecția curentă de modele din 1min.AI înainte de testare.
Un workspace multi-model poate simplifica evaluarea, dar implementarea în producție necesită în continuare integrări adecvate, analize de securitate și controale operaționale.
Verdict final: GPT-6 sau Claude 5.5?
Claude Opus 5.5 îl conduce pe GPT-6 Astra în mai multe benchmark-uri independente de inteligență și programare. Claude Sonnet 5.5 și Haiku 5.5 arată, de asemenea, rezultate solide în comparațiile publicate de Anthropic pentru munca profesională și modelele mici.
Totuși, modelele GPT-6 rămân competitive, iar GPT-6 Astra arată cum prețurile mai mari per token pot coexista cu costuri mai mici per sarcină de benchmark.
Pentru companii, nu există un câștigător universal.
Alege modelul care oferă acuratețea, fiabilitatea și compatibilitatea cu fluxul de lucru necesare la cel mai mic cost total sustenabil.
În loc să schimbi furnizorii după fiecare lansare nouă, testează mai multe modele pe sarcini reale și măsoară rezultatele.
Explorează 1min.AI pentru a compara modelele AI suportate într-un singur workspace și a găsi soluția potrivită pentru afacerea ta.
Întrebări frecvente
Este GPT-6 mai bun decât Claude 5.5?
Nu în toate benchmark-urile. Claude Opus 5.5 conduce în mai multe evaluări independente de inteligență și programare, în timp ce GPT-6 Astra performează mai bine în anumite teste și poate avea costuri mai mici per sarcină de benchmark.
Care este mai bun pentru programare: GPT-6 sau Claude 5.5?
Ambele oferă modele competitive pentru programare. Claude Opus 5.5 performează puternic pe Terminal-Bench 4.0, în timp ce GPT-6 Sol îl depășește pe Claude Sonnet 5.5 în comparația FrontierCode listată. Rezultatele depind de nivelul modelului, setarea de efort și sarcina de programare.
Care este mai ieftin: GPT-6 sau Claude 5.5?
Depinde de model și de volum. Claude Opus 5.5 are prețuri listate per token mai mici decât GPT-6 Astra, dar acesta din urmă poate folosi mai puțini tokeni per sarcină. Compară costurile totale per sarcină acceptată, nu doar prețul per token.
Este Claude 5.5 mai bun pentru documente de business?
Claude Sonnet 5.5 performează puternic în benchmark-urile publicate pentru knowledge work. Totuși, companiile ar trebui să îl compare cu modelele GPT-6 folosind propriile documente și propriile standarde de evaluare.
Pot compara GPT-6 și Claude 5.5 folosind 1min.AI?
1min.AI permite compararea răspunsurilor de la mai multe modele AI disponibile prin Multi AI Chat. Verifică lista curentă de modele a platformei pentru a confirma disponibilitatea variantelor specifice GPT-6 și Claude 5.5 pe care vrei să le evaluezi.
- #Informational
Alternative
Descoperiți cele mai bune alternative la 1minAI și comparați caracteristicile, prețurile și cazurile de utilizare.

1min.AI vs OpenRouter
1min.AI vs. OpenRouter: Comparați produsul AI gata de utilizare cu instrumentul API tehnic. Aflați dacă aveți nevoie de un studio creativ fără cod sau de un hub de infrastructură pentru programare.
 Ngoc Hong
1min. AI vs Dola AI
Cauți o alternativă la Dola AI? Compară 1min.AI vs Dola AI la generarea video, planurile gratuite, prețuri și confidențialitate pentru a alege aplicația AI potrivită.
Ngoc Hong
1minAI vs Hix AI
Compară 5 alternative HIX AI pentru chat AI, cercetare, scriere, imagini, video, prețuri și fluxuri de lucru AI flexibile.
Ngoc HongInstrumente AI
Descoperă cele mai bune instrumente AI pentru a stimula productivitatea, creativitatea și munca zilnică.

Creează conținut cartoon consecvent în doar câțiva pași
Creează videoclipuri cartoon pentru TikTok și Reels în 3 pași simpli cu 1min.AI, de la cercetarea ideilor la personaje și videoclipuri animate.
 Lien Anh Vu

Un singur produs, 10 creativități UGC: cum face AI testarea conținutului mai ușoară
Creează mai mult UGC autentic cu un generator video AI UGC, testează mai multe unghiuri creative și scalează conținutul de afiliere fără să filmezi fiecare variantă.
Lien Anh Vu
Top 4 instrumente AI accesibile pentru fondatorii de startup-uri
Descoperă top 4 instrumente AI accesibile pentru fondatorii de startup-uri, ca să validezi idei, să construiești produse, să creezi conținut și să lansezi mai repede, fără să depășești bugetul.
 Tram Ta
Funcții AI
Funcții AI complete care simplifică fluxurile de lucru, îmbunătățesc eficiența și le permit echipelor să realizeze mai mult.
Creează conținut cartoon consecvent în doar câțiva pași
Creează videoclipuri cartoon pentru TikTok și Reels în 3 pași simpli cu 1min.AI, de la cercetarea ideilor la personaje și videoclipuri animate.
Lien Anh VuUn singur produs, 10 creativități UGC: cum face AI testarea conținutului mai ușoară
Creează mai mult UGC autentic cu un generator video AI UGC, testează mai multe unghiuri creative și scalează conținutul de afiliere fără să filmezi fiecare variantă.
Lien Anh Vu
1minAI: Verificator gratuit de gramatică AI
Verifică gratuit gramatica cu verificatorul de gramatică AI de la 1minAI. Găsește greșeli de gramatică, ortografie și scriere, îmbunătățește claritatea și perfecționează-ți conținutul în câteva secunde.
Tram TaCazuri de utilizare AI
O colecție selectată de cazuri de utilizare ale AI pentru afaceri, productivitate și aplicații specifice industriei.
Creează conținut cartoon consecvent în doar câțiva pași
Creează videoclipuri cartoon pentru TikTok și Reels în 3 pași simpli cu 1min.AI, de la cercetarea ideilor la personaje și videoclipuri animate.
Lien Anh VuUn singur produs, 10 creativități UGC: cum face AI testarea conținutului mai ușoară
Creează mai mult UGC autentic cu un generator video AI UGC, testează mai multe unghiuri creative și scalează conținutul de afiliere fără să filmezi fiecare variantă.
Lien Anh Vu
Cel mai bun moment pentru a posta pe Instagram: Un ghid practic pentru un engagement mai bun
Descoperă cel mai bun moment pentru a posta pe Instagram, inclusiv cele mai bune zile și ore pentru diferite audiențe, plus sfaturi pentru a găsi programul ideal de postare pentru contul tău.
Tram TaTutoriale AI
Învață cum să folosești AI cu tutoriale practice, pas cu pas.
Creează conținut cartoon consecvent în doar câțiva pași
Creează videoclipuri cartoon pentru TikTok și Reels în 3 pași simpli cu 1min.AI, de la cercetarea ideilor la personaje și videoclipuri animate.
Lien Anh Vu
Oferte Black Friday pentru instrumente AI în 2026
Descoperiți ce au de oferit ofertele Black Friday pentru instrumente AI în 2026. Aflați cum să obțineți oferta pe viață pentru 1min.AI prin AppSumo, Dealify, Stack Social și verificați pe Trustpilot, Slashdot și Software Advice.
 Hang Nguyen
Consistența produsului în conversia AI imagine în video cu Seedance pentru a opri deformarea și a scala recenziile de produs
Oprește deformarea logo-urilor cu consistența produsului în conversia AI imagine în video și generează astăzi videoclipuri de recenzie la nivel de studio pe 1min.AI.
Lien Anh VuGhiduri AI
Învață AI mai rapid cu ghiduri practice, exemple din lumea reală și cele mai bune practici acționabile.
Creează conținut cartoon consecvent în doar câțiva pași
Creează videoclipuri cartoon pentru TikTok și Reels în 3 pași simpli cu 1min.AI, de la cercetarea ideilor la personaje și videoclipuri animate.
Lien Anh Vu
Cumpără în siguranță instrumente AI online: Ghid Black Friday 2026
Descoperă cum să găsești și să securizezi cele mai bune oferte Black Friday la AI online. Învață strategii de la experți pentru a evita escrocheriile, a combate oboseala abonamentelor și a verifica software-ul.
Hang NguyenConsistența produsului în conversia AI imagine în video cu Seedance pentru a opri deformarea și a scala recenziile de produs
Oprește deformarea logo-urilor cu consistența produsului în conversia AI imagine în video și generează astăzi videoclipuri de recenzie la nivel de studio pe 1min.AI.
Lien Anh VuSoluții AI
Răsfoiți cele mai bune soluții AI pentru automatizare, codare, cercetare, productivitate, asistență clienți, marketing și fluxuri de lucru de afaceri.
Creează conținut cartoon consecvent în doar câțiva pași
Creează videoclipuri cartoon pentru TikTok și Reels în 3 pași simpli cu 1min.AI, de la cercetarea ideilor la personaje și videoclipuri animate.
Lien Anh VuUn singur produs, 10 creativități UGC: cum face AI testarea conținutului mai ușoară
Creează mai mult UGC autentic cu un generator video AI UGC, testează mai multe unghiuri creative și scalează conținutul de afiliere fără să filmezi fiecare variantă.
Lien Anh Vu
Generator AI gratuit pentru tatuaje: designuri personalizate
Transformă orice idee într-un design de tatuaj personalizat cu generatorul AI gratuit de la 1min.AI. Descrie-ți ideea, alege un stil și descarcă în câteva secunde.
 Trang Tran
Modele AI
Explorați cele mai importante modele AI din lume într-un singur loc.
Creează conținut cartoon consecvent în doar câțiva pași
Creează videoclipuri cartoon pentru TikTok și Reels în 3 pași simpli cu 1min.AI, de la cercetarea ideilor la personaje și videoclipuri animate.
Lien Anh VuUn singur produs, 10 creativități UGC: cum face AI testarea conținutului mai ușoară
Creează mai mult UGC autentic cu un generator video AI UGC, testează mai multe unghiuri creative și scalează conținutul de afiliere fără să filmezi fiecare variantă.
Lien Anh VuConsistența produsului în conversia AI imagine în video cu Seedance pentru a opri deformarea și a scala recenziile de produs
Oprește deformarea logo-urilor cu consistența produsului în conversia AI imagine în video și generează astăzi videoclipuri de recenzie la nivel de studio pe 1min.AI.
Lien Anh VuComparații AI
Compară instrumentele, modelele și platformele AI pentru a găsi cea mai bună soluție pentru nevoile tale.

Kling AI Vs Veo 3: Care Model Câștigă?
Kling AI vs Veo 3: compară mișcarea, audio nativ, prețurile și planurile gratuite ca să vezi care generator video AI câștigă pentru proiectul tău - încearcă-le pe ambele pe 1min.AI.
Trang TranConsistența produsului în conversia AI imagine în video cu Seedance pentru a opri deformarea și a scala recenziile de produs
Oprește deformarea logo-urilor cu consistența produsului în conversia AI imagine în video și generează astăzi videoclipuri de recenzie la nivel de studio pe 1min.AI.
Lien Anh Vu
Comparație DeepSeek V4 Pro vs Flash
Compară metricile DeepSeek V4 Pro vs DeepSeek V4 Flash. Optimizează-ți aplicațiile agentice și îmbunătățește astăzi verificarea faptelor AI pe 1min.ai.
Ngoc HongIntegrări AI
Integrează AI fără efort cu instrumentele pe care le folosești deja pentru a automatiza munca și a crește productivitatea.

Cum să folosești un generator AI de videoclipuri de modă pentru Fashion Week 2026
Transformă ideile pentru Fashion Week 2026 în videoclipuri de modă spectaculoase cu AI. Află cum să faci brainstorming, să creezi vizualuri și să transformi imagini în videoclipuri cu un singur flux de lucru simplu.
Lien Anh Vu
POV: Ai peste 10 postări de creat în fiecare zi
Află cum să construiești un workflow de conținut cu AI care îi ajută pe creatorii de conținut să producă mai rapid 10+ postări pe zi pentru social media, cu brainstorming, generare de imagini și creare de conținut asistate de AI.
Lien Anh Vu
Nu mai comuta între aplicațiile AI: cum integrarea AI transformă employer branding-ul
Descoperă cum integrarea AI ajută echipele HR să eficientizeze employer branding-ul prin combinarea scrierii AI, documentelor, imaginilor, video-ului și a mai multor modele AI într-un singur spațiu de lucru.
Tram TaAI pentru Industrii
Găsiți cele mai bune instrumente și fluxuri de lucru AI pentru sănătate, finanțe, educație, juridic, producție, comerț cu amănuntul, imobiliare și multe altele.
Generator gratuit de descrieri de produs cu AI
Scrie descrieri de produs care vând în câteva minute. Folosește acest generator gratuit de descrieri de produs cu AI pentru a transforma detalii sau o fotografie în text în tonul brandului tău. Încearcă 1min.AI.
Trang Tran
Cele mai bune instrumente de productivitate pentru afaceri pentru startup-uri, pentru a maximiza profiturile | 1minAI
Descoperă cele mai bune instrumente de productivitate pentru afaceri pentru startup-uri, ca să economisești timp, să optimizezi fluxurile de lucru, să reduci sarcinile repetitive și să sprijini creșterea profitabilă cu AI.
Tram Ta
Cel mai bun instrument AI pentru content marketing |1minAI
Cauți cel mai bun instrument AI pentru content marketing? Vezi cum 1minAI îi ajută pe marketeri să cerceteze, să scrie, să refolosească, să creeze vizualuri și să scaleze conținutul dintr-un singur spațiu de lucru AI.
Tram TaAgenți AI
Descoperiți și rulați agenți AI pentru a automatiza sarcinile din munca și viața dumneavoastră de zi cu zi.
1minAI: Verificator gratuit de gramatică AI
Verifică gratuit gramatica cu verificatorul de gramatică AI de la 1minAI. Găsește greșeli de gramatică, ortografie și scriere, îmbunătățește claritatea și perfecționează-ți conținutul în câteva secunde.
Tram Ta
AI Agenți pentru Facebook
Folosește un Agent AI pentru Facebook pentru a crea conținut, a genera imagini, a programa postări și a publica din documentele și conversațiile tale.
Ngoc Hong
Agent AI vs Asistent AI: Care chiar le economisește designerilor mai mult timp?
Află diferența dintre Agent AI vs Asistent AI și descoperă ce soluție îi ajută pe designeri să automatizeze munca repetitivă, să reducă revizuirile și să economisească mai mult timp.
Lien Anh VuFluxuri de lucru AI
Explorați fluxuri de lucru AI gata de utilizare pentru productivitate, marketing, vânzări, suport și multe altele.
Creează conținut cartoon consecvent în doar câțiva pași
Creează videoclipuri cartoon pentru TikTok și Reels în 3 pași simpli cu 1min.AI, de la cercetarea ideilor la personaje și videoclipuri animate.
Lien Anh VuUn singur produs, 10 creativități UGC: cum face AI testarea conținutului mai ușoară
Creează mai mult UGC autentic cu un generator video AI UGC, testează mai multe unghiuri creative și scalează conținutul de afiliere fără să filmezi fiecare variantă.
Lien Anh VuCum să folosești un generator AI de videoclipuri de modă pentru Fashion Week 2026
Transformă ideile pentru Fashion Week 2026 în videoclipuri de modă spectaculoase cu AI. Află cum să faci brainstorming, să creezi vizualuri și să transformi imagini în videoclipuri cu un singur flux de lucru simplu.
Lien Anh VuBuletin informativ
Inovații săptămânale în AI cu 1minAI

🔮 Inovații AI săptămânale #142: Grok 4.7, Opus 5.5 și Sonnet 5.5 pe 1min.ai
Accesează Grok 4.7, Claude Opus 5.5 și Sonnet 5.5 pe 1min.ai. Reduci costurile de abonament cu până la 70% și procesezi milioane de tokeni într-un singur spațiu de lucru unificat.
Hang Nguyen
🔮 Inovații AI săptămânale #143: Actualizare Actualizare GPT-6, GPT-6.1 & Ideogram 4.0 & Ideogram 4.0
Accesează GPT-6 Sol, Luna, GPT-6.1 Sol și Ideogram 4.0 pe 1min.ai. Crește acuratețea tipografiei la 98,4% și redu latența de raționare cu 45% într-o singură platformă.
Hang Nguyen
🔮 Inovații AI săptămânale #141: Seedance 2.5 și Stable Audio 3: AI de nouă generație
Descoperă Seedance 2.0, 2.5 și Stable Audio 3 de la StabilityAI pe 1min.ai. Generează audio la standard de studio și mișcare sincronizată cu AI generativ de nouă generație.
Hang Nguyen