GPT-6 vs Claude 5.5: Qual é o melhor para negócios?

Ngoc Hong
16 de outubro de 2026
Compare GPT-6 e Claude 5.5 para programação, pesquisa e fluxos de trabalho empresariais. Descubra qual modelo de IA se encaixa nas necessidades, no orçamento e nas metas de produtividade da sua equipe.
GPT-6 vs Claude 5.5: Qual é o melhor para negócios?
GPT-6 vs Claude 5.5 é uma comparação importante para empresas que estão decidindo quais modelos de IA adotar. Tanto a OpenAI quanto a Anthropic oferecem modelos poderosos para programação, pesquisa, análise de documentos e tarefas profissionais complexas. Mas pontuações mais altas em benchmarks nem sempre se traduzem em melhores resultados de negócios.
Para líderes de IA, equipes de inovação e agências de automação, a decisão deve considerar desempenho, confiabilidade, custo e compatibilidade com o fluxo de trabalho.
Este guia compara GPT-6 e Claude 5.5 usando benchmarks publicados, especificações oficiais dos modelos e casos de uso empresariais práticos.
GPT-6 vs Claude 5.5: Principais diferenças em resumo
GPT-6 e Claude 5.5 são famílias de modelos, não modelos individuais. Cada uma inclui opções para diferentes níveis de complexidade e custo.
| Categoria | Família GPT-6 | Família Claude 5.5 |
|---|---|---|
| Desenvolvedor | OpenAI | Anthropic |
| Modelo principal | GPT-6 Astra | Claude Opus 5.5 |
| Trabalho profissional | GPT-6.1 Sol | Claude Sonnet 5.5 |
| Modelo com melhor custo | GPT-6 Luna | Claude Haiku 5.5 |
| Principais pontos fortes | Raciocínio avançado, programação, uso de computador | Análise complexa, programação, trabalho do conhecimento |
| Principal consideração de negócio | Capacidade versus custo da tarefa | Qualidade, eficiência e adequação à carga |
A OpenAI posiciona Astra para suas tarefas mais exigentes e GPT-6.1 Sol para capacidade próxima da principal a um preço mais baixo. A Anthropic posiciona Opus para julgamentos complexos, Sonnet para trabalho profissional do dia a dia e Haiku para operações de alto volume.
Veredito rápido: Claude Opus 5.5 supera GPT-6 Astra em vários benchmarks independentes de inteligência e programação. No entanto, GPT-6 Astra pode concluir certas cargas de benchmark com menos tokens e menor custo total por tarefa.
A melhor escolha para o negócio depende de quais trade-offs importam mais.
Fontes: OpenAI GPT-6 Model Guide | Anthropic Claude Sonnet 5.5
GPT-6 vs Claude 5.5 Benchmarks: Qual tem melhor desempenho?
Benchmarks independentes ajudam as empresas a avaliar as capacidades dos modelos além das alegações de marketing.
A Artificial Analysis compara Claude Opus 5.5 e GPT-6 Astra em raciocínio, programação, automação, custo e velocidade.
GPT-6 Astra vs Claude Opus 5.5: Benchmarks independentes
Os resultados a seguir comparam ambos os modelos nas suas configurações de esforço de raciocínio Max.
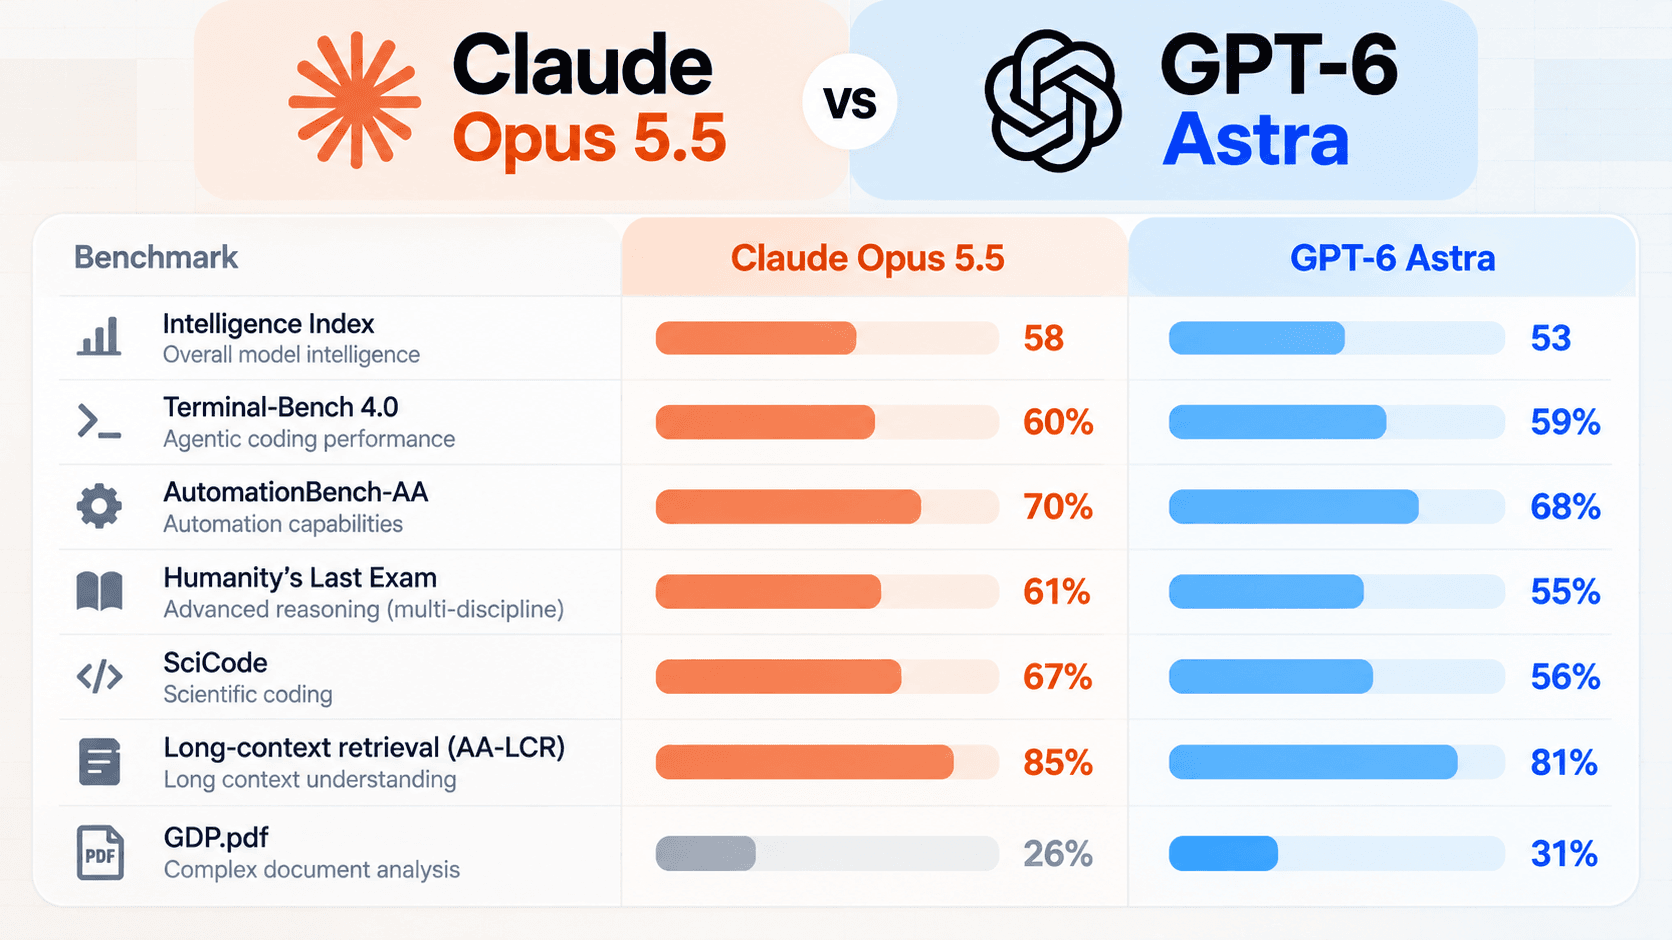
Fonte: Artificial Analysis — Claude Opus 5.5 vs GPT-6 Astra (Max)
Claude Opus 5.5 lidera em inteligência geral, programação científica e várias avaliações avançadas de raciocínio.
GPT-6 Astra tem melhor desempenho em GDP.pdf, mostrando que os resultados não favorecem o Claude de forma uniforme.
Essas pontuações também refletem configurações de teste específicas. Uma configuração diferente de esforço de raciocínio pode alterar tanto o desempenho quanto o custo.
O que esses benchmarks significam para o negócio?
Diferentes benchmarks medem capacidades diferentes.
- Terminal-Bench 4.0: Avalia a capacidade de um agente de IA de concluir tarefas usando ferramentas baseadas em terminal.
- AutomationBench-AA: Mede o desempenho em tarefas orientadas à automação.
- Humanity's Last Exam: Testa conhecimento avançado e raciocínio entre disciplinas.
- SciCode: Avalia capacidades de programação científica.
- AA-LCR: Mede a precisão de recuperação em longos contextos.
Para uma agência de automação, Terminal-Bench e AutomationBench podem ser mais relevantes do que pontuações gerais de conhecimento.
Para uma equipe de pesquisa corporativa, recuperação em longo contexto e precisão factual podem importar mais.
O ponto-chave é escolher benchmarks que se pareçam com sua carga real de trabalho.
GPT-6 vs Claude 5.5: Velocidade, janela de contexto e custo
Desempenho é apenas uma parte da decisão.
A Artificial Analysis também apresenta as seguintes especificações e medições operacionais para os modelos principais no esforço Max.
| Métrica | Claude Opus 5.5 | GPT-6 Astra |
|---|---|---|
| Janela de contexto | 1M tokens | 1M tokens |
| Preço de entrada / 1M tokens | $4 | $10 |
| Preço de saída / 1M tokens | $20 | $50 |
| Velocidade de saída | 95 tokens/s | 61 tokens/s |
| Custo médio por tarefa de benchmark | $5,98 | $3,26 |
Fonte: Artificial Analysis — Flagship Model Comparison
Claude Opus 5.5 tem preços de tokens mais baixos e geração de saída medida mais rápida.
No entanto, GPT-6 Astra tem um custo médio por tarefa de benchmark mais baixo nessa configuração.
Por quê?
Os modelos podem consumir números diferentes de tokens de raciocínio e saída para resolver o mesmo problema. Um modelo com preços de token mais altos ainda pode custar menos por tarefa concluída se usar significativamente menos tokens.
Para empresas, isso torna o custo por tarefa aceita mais útil do que apenas o preço por token.
Esses números descrevem o ambiente de avaliação da Artificial Analysis, não latência ou custo garantidos em produção.
GPT-6 Sol vs Claude Sonnet 5.5: Trabalho empresarial do dia a dia
Modelos principais nem sempre são necessários para as operações diárias.
GPT-6 Sol e Claude Sonnet 5.5 são alternativas relevantes para redação profissional, programação e trabalho do conhecimento.
A comparação publicada pela Anthropic mostra:
| Benchmark | Claude Sonnet 5.5 | GPT-6 Sol |
|---|---|---|
| FrontierCode 1.1 (Main) | 46,2% (Max) | 49,3% |
| GDPval-AA v2.1 | 1.844 | 1.487 |
| AA-Briefcase v1.1 | 1.811 | 1.483 |
| Preço de entrada / 1M tokens | $2 | $2 |
| Preço de saída / 1M tokens | $10 | $10 |
Fonte: Anthropic — Claude Sonnet 5.5 Performance Benchmarks
GPT-6 Sol tem pontuação mais alta no resultado FrontierCode listado, enquanto Claude Sonnet 5.5 lidera nas avaliações de trabalho do conhecimento.
A Anthropic também informa que o Sonnet 5.5 é mais de 30% mais rápido que o Sonnet 5 e custa até 30% menos na maioria das cargas de trabalho.
Essas são comparações publicadas pela Anthropic, e as configurações de esforço ou as condições de avaliação podem diferir entre os modelos.
Para empresas, ambos os modelos valem testes em relatórios, apresentações, desenvolvimento de software e outras tarefas profissionais recorrentes.
GPT-6 Luna vs Claude Haiku 5.5: Tarefas de IA em alto volume
Modelos menores podem oferecer melhor economia para operações repetitivas.
Claude Haiku 5.5 e GPT-6 Luna atendem cargas sensíveis a custo, nas quais velocidade e eficiência importam.
A Anthropic informa os seguintes resultados de benchmark:
| Benchmark | Claude Haiku 5.5 | GPT-6 Luna |
|---|---|---|
| Terminal-Bench 4.0 | 39,2% | 16,4% |
| OSWorld 2.1 (offline subset) | 72,4% | 48,9% |
| FrontierCode 1.1 | 46,4% | 42,4% |
| GDPval-AA v2.1 | 1.620 | 1.437 |
| Preço de entrada / 1M tokens | $0,10* | $0,10 |
| Preço de saída / 1M tokens | $0,50* | $0,50 |
Fonte: Anthropic — Claude Haiku 5.5 Benchmarks
Os preços listados do Claude Haiku 5.5 se aplicam a prompts de até 100.000 tokens; prompts mais longos têm preços diferentes.
Nas avaliações publicadas pela Anthropic, Haiku 5.5 supera Luna em todas as tarefas listadas.
Para empresas que processam grandes volumes de solicitações de clientes, documentos ou dados estruturados, esses resultados tornam o Haiku 5.5 digno de teste.
No entanto, as organizações devem verificar se essas vantagens se mantêm para seus próprios inputs e requisitos de latência.
GPT-6 vs Claude 5.5 para casos de uso empresariais
O melhor modelo depende do que sua organização precisa realizar.
Programação e desenvolvimento de software
As duas famílias de modelos oferecem fortes candidatos para desenvolvimento de software.
GPT-6 Astra e Claude Opus 5.5 são relevantes para tarefas complexas de programação, enquanto GPT-6.1 Sol e Claude Sonnet 5.5 oferecem alternativas para o trabalho de desenvolvimento do dia a dia.
As empresas devem avaliar a qualidade do código usando repositórios reais, e não apenas pontuações de benchmark.
Meça testes aprovados, tempo de depuração, manutenibilidade e número de revisões necessárias.
Para agências de automação com IA, essas métricas costumam ser mais úteis do que a velocidade bruta de geração de código.
Pesquisa e análise complexa
Fluxos de trabalho de pesquisa exigem informações precisas, raciocínio claro e interpretação confiável do material de origem.
Os resultados do Claude Opus 5.5 em benchmarks de raciocínio avançado e longo contexto fazem dele um forte candidato para avaliação.
GPT-6 Astra também oferece recursos para pesquisa complexa, análise de dados e tarefas profissionais.
Para qualquer um dos modelos, as organizações devem verificar afirmações importantes em fontes confiáveis e incluir revisão humana quando as decisões tiverem consequências significativas.
Documentos empresariais e trabalho do conhecimento
As equipes usam IA com frequência para redigir relatórios, analisar documentos, preparar apresentações e resumir informações internas.
Claude Sonnet 5.5 tem bom desempenho em benchmarks publicados de trabalho do conhecimento, o que o torna digno de avaliação para operações intensivas em documentos.
GPT-6 Sol e GPT-6.1 Sol também são candidatos relevantes para produtividade profissional.
A melhor escolha deve se basear em precisão factual, qualidade da formatação, esforço de edição e consistência com os requisitos da organização.
Automação por IA e operações de alto volume
Equipes de automação precisam de modelos que entreguem resultados aceitáveis repetidamente, sem custos desnecessários.
Claude Haiku 5.5 e GPT-6 Luna são relevantes para classificação, extração estruturada e processamento rotineiro.
No entanto, pontuações de benchmark por si só não estabelecem confiabilidade em produção.
As equipes também devem avaliar tratamento de erros, validação de saída, limites de taxa e requisitos de integração.
Como escolher entre GPT-6 e Claude 5.5 para obter melhor ROI
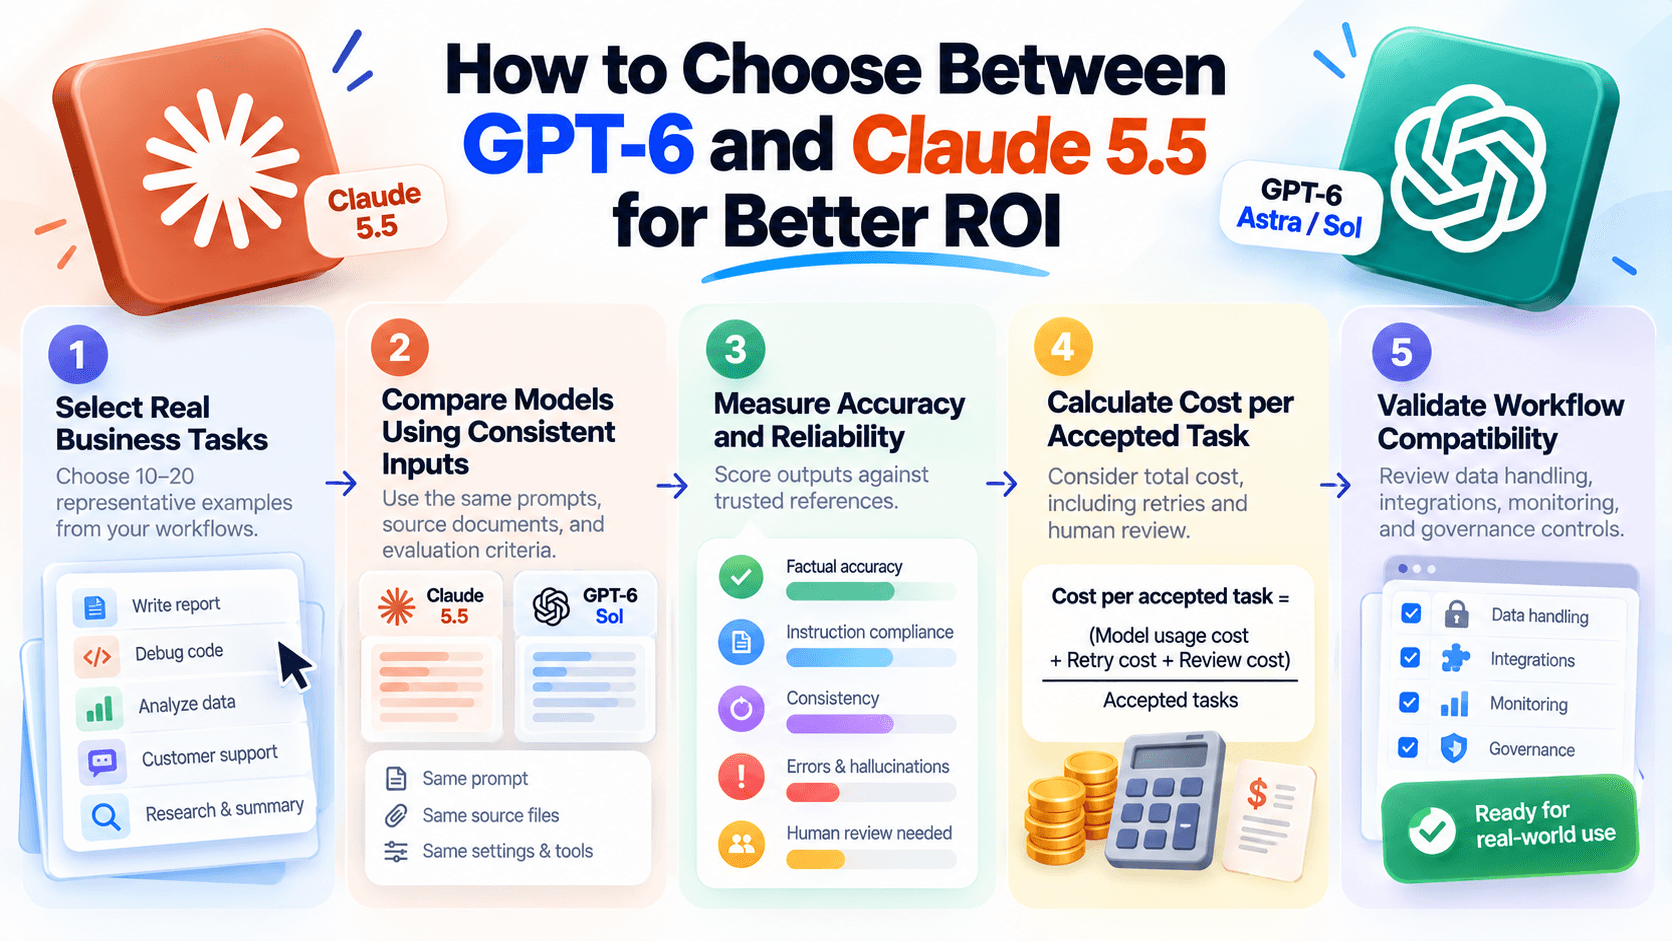
Líderes de IA devem avaliar modelos com base em resultados de negócio mensuráveis, e não apenas em rankings públicos.
Uma estrutura prática inclui cinco etapas.
1. Selecione tarefas reais de negócio
Escolha de 10 a 20 exemplos representativos dos seus fluxos de trabalho.
Inclua solicitações simples, tarefas complexas e casos em que seu modelo atual falha com frequência.
2. Compare os modelos usando inputs consistentes
Use prompts equivalentes, documentos de origem e critérios de avaliação.
Para uma comparação justa, documente as configurações de esforço de raciocínio e as ferramentas disponíveis para cada modelo.
3. Meça precisão e confiabilidade
Avalie as saídas com base em referências confiáveis.
Acompanhe erros factuais, conformidade com instruções, consistência e quantidade de correção humana necessária.
4. Calcule o custo por tarefa aceita
Em vez de focar apenas no preço por token, calcule:
Custo por tarefa aceita = (custo de uso do modelo + custo de repetição + custo de revisão) ÷ tarefas aceitas
Isso captura o gasto real para produzir resultados utilizáveis.
5. Valide a compatibilidade com o fluxo de trabalho
Antes de implantar um modelo, revise os requisitos de tratamento de dados, integrações, monitoramento e controles de governança.
Um modelo que tenha bom desempenho em testes ainda pode exigir trabalho significativo de integração antes de estar pronto para produção.
Para uma estrutura de seleção mais ampla, leia Best AI Chatbot for Business: How to Compare Options.
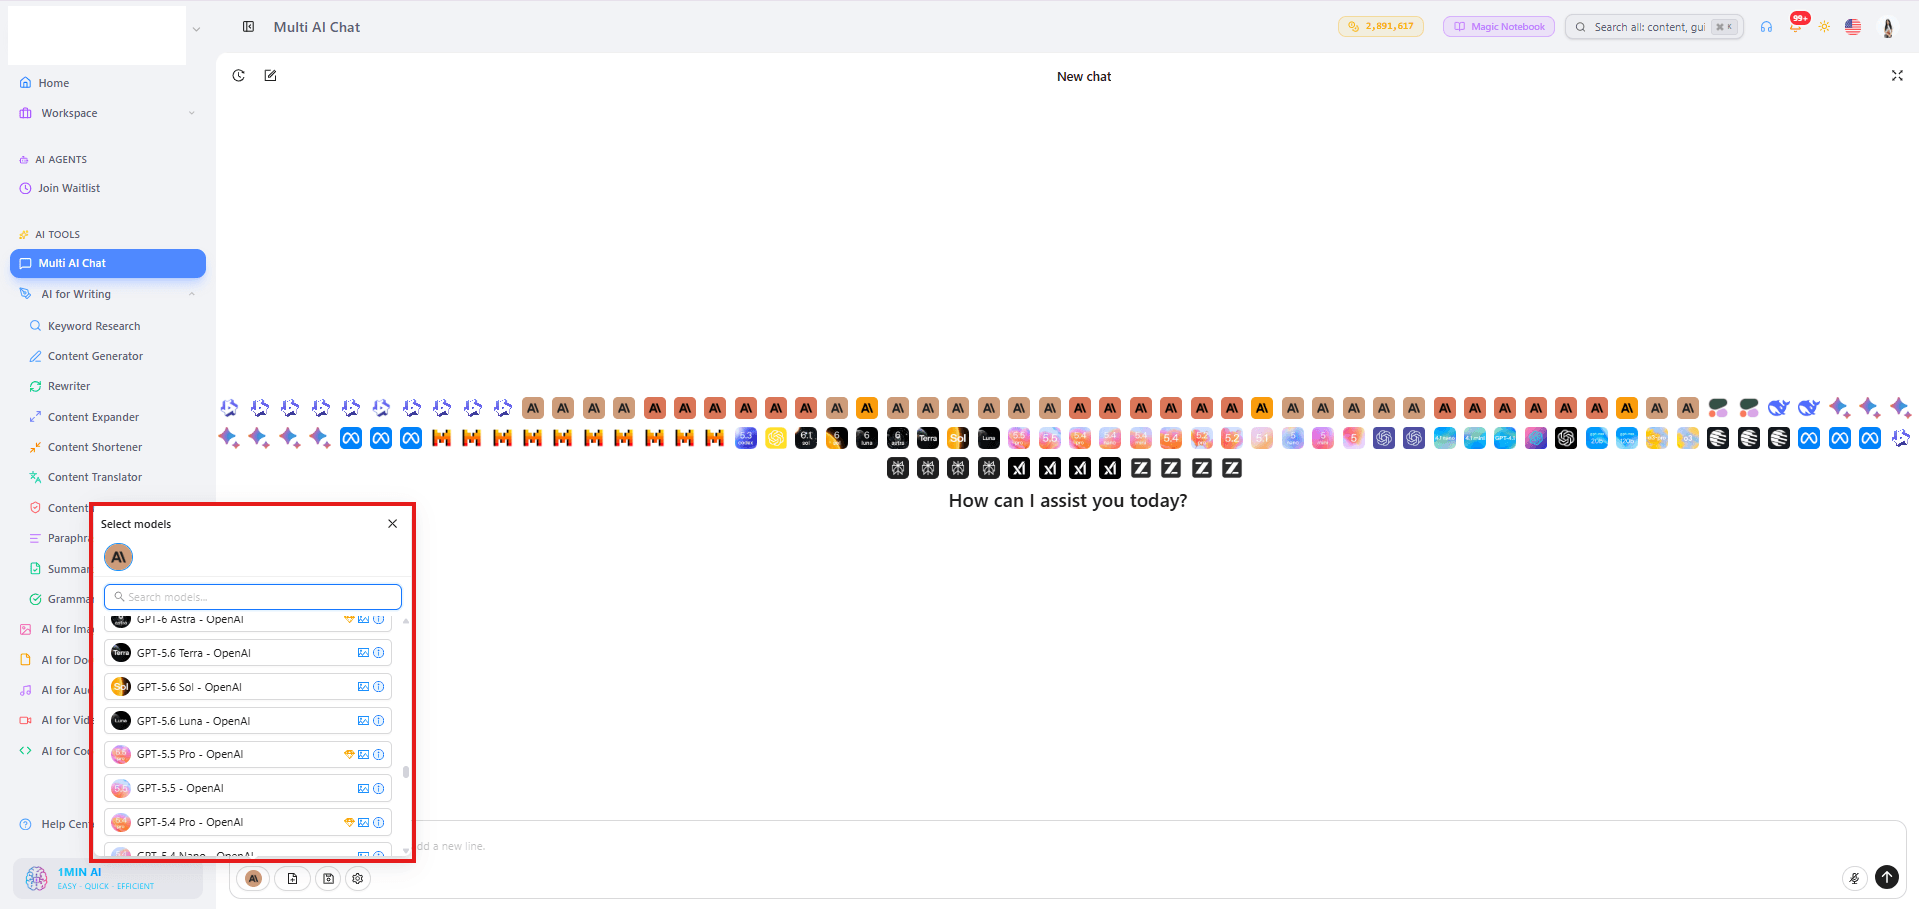
Compare modelos de IA em um único workspace com 1min.AI
Testar modelos em interfaces separadas pode tornar as comparações mais difíceis de gerenciar.
1min.AI oferece um workspace unificado para acessar vários modelos de IA compatíveis e concluir tarefas com IA.
Com o Multi AI Chat, as equipes podem enviar o mesmo prompt aos modelos compatíveis e comparar respostas lado a lado.
Mix AI Models permite trabalhar com diferentes modelos dentro de uma conversa, enquanto o Document Chat ajuda os usuários a interagir com documentos empresariais.
Para AI Champions e equipes de inovação, esses recursos oferecem um ponto de partida prático para comparar saídas de modelos antes de avançar para uma implementação mais ampla.
As variantes específicas de GPT-6 e Claude 5.5 devem ser verificadas na seleção atual de modelos do 1min.AI antes dos testes.
Um workspace multimodelo pode simplificar a avaliação, mas a implantação em produção ainda exige integrações adequadas, revisões de segurança e controles operacionais.
Veredito final: GPT-6 ou Claude 5.5?
Claude Opus 5.5 supera GPT-6 Astra em vários benchmarks independentes de inteligência e programação. Claude Sonnet 5.5 e Haiku 5.5 também mostram resultados fortes nas comparações publicadas pela Anthropic de trabalho profissional e de modelos pequenos.
No entanto, os modelos GPT-6 continuam competitivos, e GPT-6 Astra mostra como preços de token mais altos podem coexistir com custos mais baixos por tarefa de benchmark.
Para as empresas, não existe um vencedor universal.
Escolha o modelo que ofereça a precisão, a confiabilidade e a compatibilidade com o fluxo de trabalho necessárias, pelo menor custo total sustentável.
Em vez de trocar de fornecedor com base no lançamento mais recente, teste vários modelos em cargas de trabalho reais e meça os resultados.
Explore a 1min.AI para comparar modelos de IA compatíveis em um único workspace e encontrar a opção ideal para o seu negócio.
Perguntas frequentes
GPT-6 é melhor que Claude 5.5?
Não em todos os benchmarks. Claude Opus 5.5 lidera em várias avaliações independentes de inteligência e programação, enquanto GPT-6 Astra tem melhor desempenho em certos testes e pode ter custos menores por tarefa de benchmark.
Qual é melhor para programação: GPT-6 ou Claude 5.5?
Ambos oferecem modelos competitivos para programação. Claude Opus 5.5 tem bom desempenho em Terminal-Bench 4.0, enquanto GPT-6 Sol supera Claude Sonnet 5.5 na comparação FrontierCode listada. Os resultados dependem do nível do modelo, da configuração de esforço e da tarefa de programação.
Qual é mais barato: GPT-6 ou Claude 5.5?
Depende do modelo e da carga de trabalho. Claude Opus 5.5 tem preços de token listados mais baixos que GPT-6 Astra, mas este último pode usar menos tokens por tarefa. Compare o custo total por tarefa aceita, e não apenas o preço por token.
Claude 5.5 é melhor para documentos empresariais?
Claude Sonnet 5.5 tem bom desempenho em benchmarks publicados de trabalho do conhecimento. No entanto, as empresas devem compará-lo com os modelos GPT-6 usando seus próprios documentos e padrões de avaliação.
Posso comparar GPT-6 e Claude 5.5 usando a 1min.AI?
A 1min.AI permite comparar respostas de vários modelos de IA disponíveis por meio do Multi AI Chat. Verifique a lista atual de modelos da plataforma para confirmar a disponibilidade das variantes específicas de GPT-6 e Claude 5.5 que você quer avaliar.
- #Informational
Alternativas
Descubra as melhores alternativas ao 1minAI e compare recursos, preços e casos de uso.
1min.AI vs OpenRouter
1min.AI vs. OpenRouter: Compare o produto de criação de IA pronto para usar com a ferramenta técnica de API. Descubra se você precisa de um estúdio criativo sem código ou de um hub de infraestrutura para programação.
 Ngoc Hong
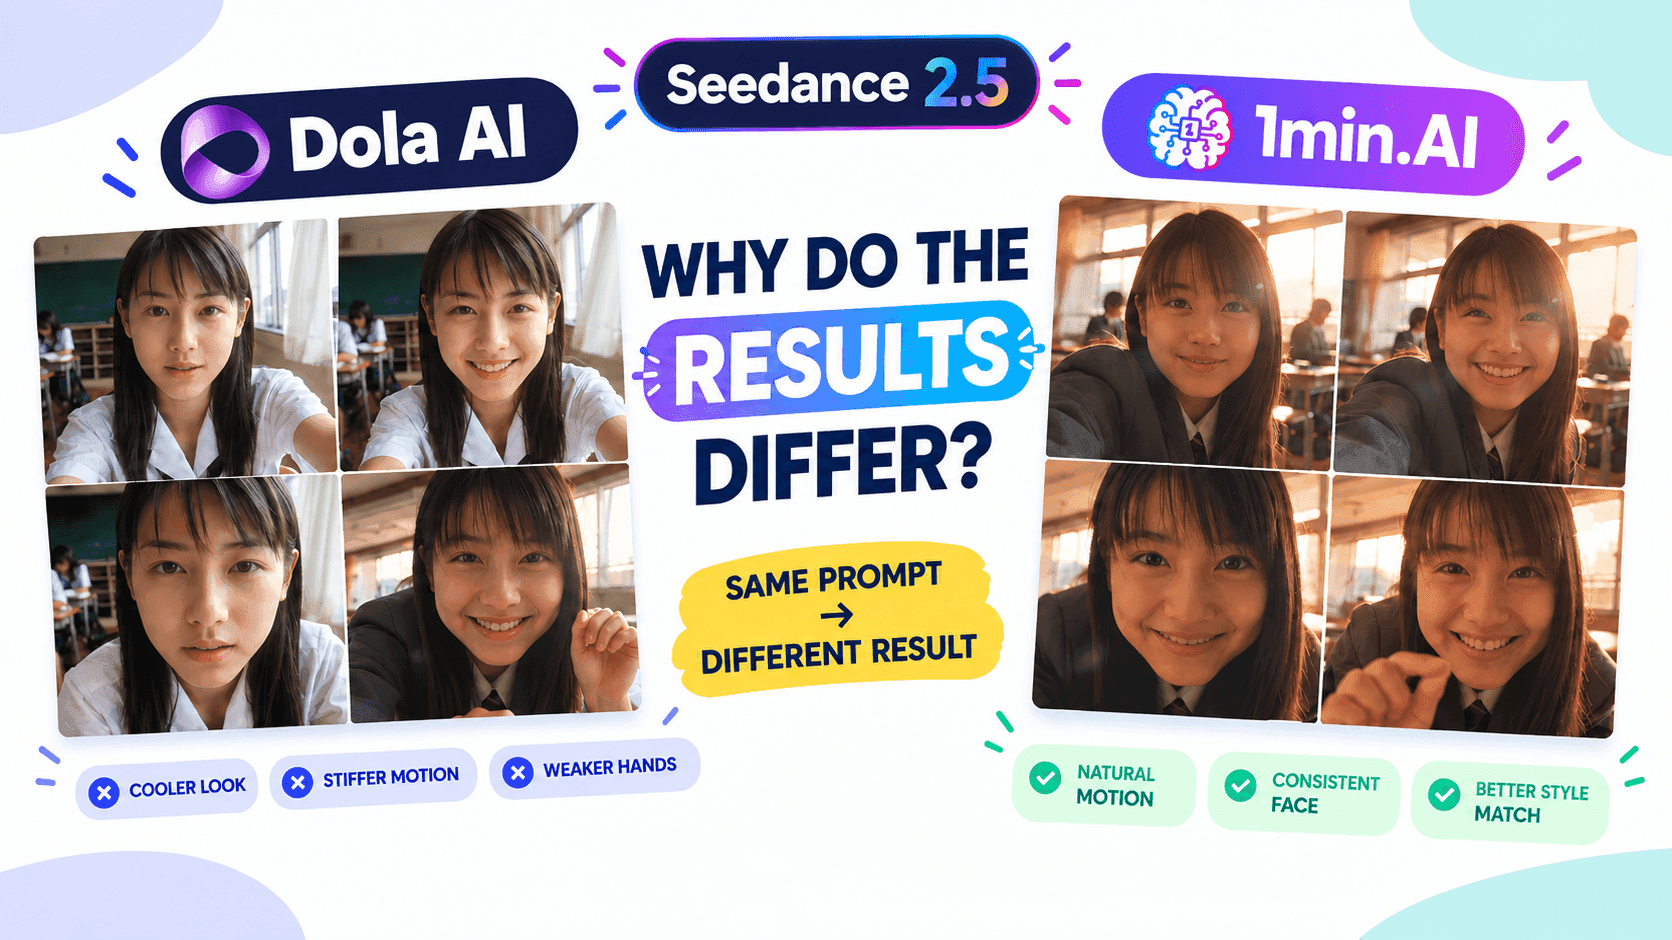
1min. AI vs Dola AI
Procurando uma alternativa ao Dola AI? Compare 1min.AI vs Dola AI em geração de vídeo, planos grátis, preços e privacidade para escolher o app de IA certo.
Ngoc Hong
1minAI vs Hix AI
Compare 5 alternativas ao HIX AI para chat com IA, pesquisa, escrita, imagens, vídeo, preços e fluxos de trabalho flexíveis com IA.
Ngoc HongFerramentas de IA
Descubra as melhores ferramentas de IA para aumentar a produtividade, a criatividade e o trabalho diário.
Um Produto, 10 Criativos UGC: Como a IA Torna o Teste de Conteúdo Mais Fácil
Crie UGC mais autêntico com um gerador de vídeos UGC com IA, teste mais ângulos criativos e escale conteúdo de afiliados sem filmar cada versão.
 Lien Anh Vu
Crie conteúdo de desenho animado consistente em apenas alguns passos
Crie vídeos de desenho animado para TikTok e Reels em 3 passos simples com o 1min.AI, da pesquisa de ideias aos personagens e vídeos animados.
Lien Anh Vu
As 4 Melhores Ferramentas de IA Acessíveis para Fundadores de Startups
Descubra as 4 melhores ferramentas de IA acessíveis para fundadores de startups validarem ideias, criarem produtos, produzirem conteúdo e lançarem mais rápido sem gastar além da conta.
 Tram Ta
Recursos de IA
Recursos abrangentes de IA que agilizam fluxos de trabalho, aumentam a eficiência e capacitam as equipes a alcançar mais.
Um Produto, 10 Criativos UGC: Como a IA Torna o Teste de Conteúdo Mais Fácil
Crie UGC mais autêntico com um gerador de vídeos UGC com IA, teste mais ângulos criativos e escale conteúdo de afiliados sem filmar cada versão.
Lien Anh VuCrie conteúdo de desenho animado consistente em apenas alguns passos
Crie vídeos de desenho animado para TikTok e Reels em 3 passos simples com o 1min.AI, da pesquisa de ideias aos personagens e vídeos animados.
Lien Anh Vu
1minAI: Verificador Gratuito de Gramática com IA
Verifique a gramática gratuitamente com o verificador de gramática com IA da 1minAI. Encontre erros de gramática, ortografia e escrita, melhore a clareza e aperfeiçoe seu conteúdo em segundos.
Tram TaCasos de Uso de IA
Uma coleção curada de casos de uso de IA para negócios, produtividade e aplicações específicas por setor.
Um Produto, 10 Criativos UGC: Como a IA Torna o Teste de Conteúdo Mais Fácil
Crie UGC mais autêntico com um gerador de vídeos UGC com IA, teste mais ângulos criativos e escale conteúdo de afiliados sem filmar cada versão.
Lien Anh VuCrie conteúdo de desenho animado consistente em apenas alguns passos
Crie vídeos de desenho animado para TikTok e Reels em 3 passos simples com o 1min.AI, da pesquisa de ideias aos personagens e vídeos animados.
Lien Anh Vu
Melhor Horário para Postar no Instagram: Um Guia Prático para Melhor Engajamento
Descubra o melhor horário para postar no Instagram, incluindo os melhores dias e horários para diferentes públicos, além de dicas para encontrar a agenda ideal de publicações para sua conta.
Tram TaTutoriais de IA
Aprenda a usar IA com tutoriais práticos e passo a passo.
Crie conteúdo de desenho animado consistente em apenas alguns passos
Crie vídeos de desenho animado para TikTok e Reels em 3 passos simples com o 1min.AI, da pesquisa de ideias aos personagens e vídeos animados.
Lien Anh Vu
Ofertas de ferramentas de IA na Black Friday em 2026
Descubra o que as ofertas de ferramentas de IA da Black Friday 2026 têm a oferecer. Veja como garantir a oferta vitalícia do 1min.AI via AppSumo, Dealify, Stack Social, e verifique no Trustpilot, Slashdot e Software Advice.
 Hang Nguyen
Consistência de Produto em Imagem para Vídeo com IA e Seedance para Parar Distorções e Escalar Avaliações de Produtos
Pare de distorcer logos com consistência de produto em imagem para vídeo com IA e gere vídeos de avaliações com padrão de estúdio hoje mesmo na 1min.AI.
Lien Anh VuGuias de IA
Aprenda IA mais rápido com guias práticos, exemplos do mundo real e melhores práticas acionáveis.
Crie conteúdo de desenho animado consistente em apenas alguns passos
Crie vídeos de desenho animado para TikTok e Reels em 3 passos simples com o 1min.AI, da pesquisa de ideias aos personagens e vídeos animados.
Lien Anh Vu
Compre Ferramentas de IA Online com Segurança: Guia de Black Friday 2026
Descubra como encontrar e garantir as melhores ofertas de Black Friday em IA online. Aprenda estratégias de especialistas para evitar golpes, combater a fadiga de assinaturas e verificar softwares.
Hang NguyenConsistência de Produto em Imagem para Vídeo com IA e Seedance para Parar Distorções e Escalar Avaliações de Produtos
Pare de distorcer logos com consistência de produto em imagem para vídeo com IA e gere vídeos de avaliações com padrão de estúdio hoje mesmo na 1min.AI.
Lien Anh VuSoluções de IA
Explore as melhores soluções de IA para automação, codificação, pesquisa, produtividade, suporte ao cliente, marketing e fluxos de trabalho de negócios.
Um Produto, 10 Criativos UGC: Como a IA Torna o Teste de Conteúdo Mais Fácil
Crie UGC mais autêntico com um gerador de vídeos UGC com IA, teste mais ângulos criativos e escale conteúdo de afiliados sem filmar cada versão.
Lien Anh VuCrie conteúdo de desenho animado consistente em apenas alguns passos
Crie vídeos de desenho animado para TikTok e Reels em 3 passos simples com o 1min.AI, da pesquisa de ideias aos personagens e vídeos animados.
Lien Anh Vu
Gerador Gratuito de Tatuagem com IA: Designs Personalizados
Transforme qualquer ideia em um design de tatuagem personalizado com o gerador gratuito de tatuagem com IA da 1min.AI. Descreva sua ideia, escolha um estilo e baixe em segundos.
 Trang Tran
Modelos de IA
Explore os principais modelos de IA do mundo em um só lugar.
Um Produto, 10 Criativos UGC: Como a IA Torna o Teste de Conteúdo Mais Fácil
Crie UGC mais autêntico com um gerador de vídeos UGC com IA, teste mais ângulos criativos e escale conteúdo de afiliados sem filmar cada versão.
Lien Anh VuCrie conteúdo de desenho animado consistente em apenas alguns passos
Crie vídeos de desenho animado para TikTok e Reels em 3 passos simples com o 1min.AI, da pesquisa de ideias aos personagens e vídeos animados.
Lien Anh VuConsistência de Produto em Imagem para Vídeo com IA e Seedance para Parar Distorções e Escalar Avaliações de Produtos
Pare de distorcer logos com consistência de produto em imagem para vídeo com IA e gere vídeos de avaliações com padrão de estúdio hoje mesmo na 1min.AI.
Lien Anh VuComparações de IA
Compare ferramentas, modelos e plataformas de IA para encontrar a melhor opção para suas necessidades.
Kling AI Vs Veo 3: Qual Modelo Vence?
Kling AI vs Veo 3: compare movimento, áudio nativo, preços e planos gratuitos para ver qual gerador de vídeo com IA vence para o seu projeto — teste ambos no 1min.AI.
Trang TranConsistência de Produto em Imagem para Vídeo com IA e Seedance para Parar Distorções e Escalar Avaliações de Produtos
Pare de distorcer logos com consistência de produto em imagem para vídeo com IA e gere vídeos de avaliações com padrão de estúdio hoje mesmo na 1min.AI.
Lien Anh Vu
Comparação DeepSeek V4 Pro vs Flash
Compare as métricas do DeepSeek V4 Pro vs DeepSeek V4 Flash. Otimize seus apps agentic e melhore a checagem de fatos por IA na 1min.ai hoje.
Ngoc HongIntegrações de IA
Integre IA perfeitamente às ferramentas que você já usa para automatizar tarefas e aumentar a produtividade.
Como Usar um Gerador de Vídeos de Moda com IA para a Fashion Week 2026
Transforme ideias da Fashion Week 2026 em vídeos de moda impressionantes com IA. Aprenda a fazer brainstorming, criar visuais e transformar imagens em vídeos com um fluxo de trabalho simples.
Lien Anh Vu
POV: Você tem mais de 10 posts para criar todo dia
Aprenda a criar um fluxo de trabalho de conteúdo com IA que ajuda criadores a produzir mais de 10 posts por dia para redes sociais com mais rapidez, usando brainstorming com IA, geração de imagens e criação de conteúdo.
Lien Anh Vu
Pare de Alternar Entre Apps de IA: Como a Integração de IA Transforma o Employer Branding
Descubra como a integração de IA ajuda equipes de RH a agilizar o employer branding ao combinar redação com IA, documentos, imagens, vídeo e vários modelos de IA em um só espaço de trabalho.
Tram TaIA para Indústrias
Encontre as melhores ferramentas e fluxos de trabalho de IA para saúde, finanças, educação, jurídico, manufatura, varejo, imóveis e muito mais.
Gerador Gratuito de Descrição de Produto com IA
Escreva descrições de produtos que vendem em minutos. Use este gerador gratuito de descrição de produto com IA para transformar detalhes ou uma foto em textos alinhados à sua marca. Experimente o 1min.AI.
Trang Tran
Melhores Ferramentas de Produtividade Empresarial para Startups Maximizarem os Lucros | 1minAI
Descubra as melhores ferramentas de produtividade empresarial para startups economizarem tempo, simplificarem fluxos de trabalho, reduzirem tarefas repetitivas e impulsionarem um crescimento lucrativo com IA.
Tram Ta
Melhor Ferramenta de IA para Marketing de Conteúdo |1minAI
Procurando a melhor ferramenta de IA para marketing de conteúdo? Veja como a 1minAI ajuda profissionais de marketing a pesquisar, escrever, reaproveitar, criar visuais e escalar conteúdo em um só workspace de IA.
Tram TaAgentes de IA
Descubra e execute agentes de IA para automatizar tarefas em seu trabalho e vida diária.
1minAI: Verificador Gratuito de Gramática com IA
Verifique a gramática gratuitamente com o verificador de gramática com IA da 1minAI. Encontre erros de gramática, ortografia e escrita, melhore a clareza e aperfeiçoe seu conteúdo em segundos.
Tram Ta
Agentes de IA para Facebook
Use um Agente de IA para Facebook para criar conteúdo, gerar imagens, agendar publicações e publicar a partir dos seus documentos e conversas.
Ngoc Hong
Agente de IA vs Assistente de IA: Qual realmente economiza mais tempo para designers?
Aprenda a diferença entre Agente de IA vs Assistente de IA e descubra qual solução ajuda designers a automatizar tarefas repetitivas, reduzir revisões e economizar mais tempo.
Lien Anh VuFluxos de Trabalho de IA
Explore fluxos de trabalho de IA prontos para uso para produtividade, marketing, vendas, suporte e muito mais.
Um Produto, 10 Criativos UGC: Como a IA Torna o Teste de Conteúdo Mais Fácil
Crie UGC mais autêntico com um gerador de vídeos UGC com IA, teste mais ângulos criativos e escale conteúdo de afiliados sem filmar cada versão.
Lien Anh VuCrie conteúdo de desenho animado consistente em apenas alguns passos
Crie vídeos de desenho animado para TikTok e Reels em 3 passos simples com o 1min.AI, da pesquisa de ideias aos personagens e vídeos animados.
Lien Anh VuComo Usar um Gerador de Vídeos de Moda com IA para a Fashion Week 2026
Transforme ideias da Fashion Week 2026 em vídeos de moda impressionantes com IA. Aprenda a fazer brainstorming, criar visuais e transformar imagens em vídeos com um fluxo de trabalho simples.
Lien Anh VuBoletim informativo
Inovações semanais em IA com 1minAI
🔮 Inovações Semanais em IA #142: Grok 4.7, Opus 5.5 & Sonnet 5.5 na 1min.ai
Acesse Grok 4.7, Claude Opus 5.5 e Sonnet 5.5 na 1min.ai. Reduza os custos de assinatura em até 70% e processe milhões de tokens em um espaço de trabalho unificado.
Hang Nguyen
🔮 Inovações Semanais em IA #143: Atualização GPT-6, GPT-6.1 & Ideogram 4.0 & Ideogram 4.0
Acesse GPT-6 Sol, Luna, GPT-6.1 Sol e Ideogram 4.0 no 1min.ai. Aumente a precisão de tipografia para 98,4% e reduza a latência de raciocínio em 45% em uma única plataforma.
Hang Nguyen
🔮 Inovações Semanais em IA #141: Seedance 2.5 & Stable Audio 3: IA de Próxima Geração
Explore o Seedance 2.0, 2.5 e o Stable Audio 3 da StabilityAI no 1min.ai. Gere áudio de nível de estúdio e movimento sincronizado com IA generativa de próxima geração.
Hang Nguyen