GPT-6 vs Claude 5.5: ¿Cuál es mejor para los negocios?

Ngoc Hong
16 de octubre de 2026
Compara GPT-6 y Claude 5.5 para programación, investigación y flujos de trabajo empresariales. Descubre qué modelo de IA se ajusta a las necesidades, el presupuesto y los objetivos de productividad de tu equipo.
GPT-6 vs Claude 5.5: ¿Cuál es mejor para los negocios?
GPT-6 vs Claude 5.5 es una comparación importante para las empresas que deciden qué modelos de IA adoptar. Tanto OpenAI como Anthropic ofrecen modelos potentes para programación, investigación, análisis de documentos y tareas profesionales complejas. Pero unas mejores puntuaciones en benchmarks no siempre se traducen en mejores resultados de negocio.
Para líderes de IA, equipos de innovación y agencias de automatización, la decisión debe considerar el rendimiento, la confiabilidad, el costo y la compatibilidad con los flujos de trabajo.
Esta guía compara GPT-6 y Claude 5.5 usando benchmarks publicados, especificaciones oficiales del modelo y casos de uso empresariales prácticos.
GPT-6 vs Claude 5.5: diferencias clave de un vistazo
GPT-6 y Claude 5.5 son familias de modelos, no modelos individuales. Cada una incluye opciones para distintos niveles de complejidad y costo.
| Category | GPT-6 family | Claude 5.5 family |
|---|---|---|
| Developer | OpenAI | Anthropic |
| Flagship model | GPT-6 Astra | Claude Opus 5.5 |
| Professional work | GPT-6.1 Sol | Claude Sonnet 5.5 |
| Cost-efficient model | GPT-6 Luna | Claude Haiku 5.5 |
| Key strengths to evaluate | Advanced reasoning, coding, computer use | Complex analysis, coding, knowledge work |
| Main business consideration | Capability versus task cost | Quality, efficiency, and workload fit |
OpenAI posiciona Astra para sus tareas más exigentes y GPT-6.1 Sol para una capacidad casi insignia a un precio más bajo. Anthropic posiciona Opus para el juicio complejo, Sonnet para el trabajo profesional diario y Haiku para operaciones de alto volumen.
Veredicto rápido: Claude Opus 5.5 supera a GPT-6 Astra en varios benchmarks independientes de inteligencia y programación. Sin embargo, GPT-6 Astra puede completar ciertas cargas de benchmark con menos tokens y un menor costo total por tarea.
La mejor opción para el negocio depende de qué compromisos sean más importantes.
Sources: OpenAI GPT-6 Model Guide | Anthropic Claude Sonnet 5.5
GPT-6 vs Claude 5.5 benchmarks: ¿cuál rinde mejor?
Los benchmarks independientes ayudan a las empresas a evaluar las capacidades del modelo más allá de las afirmaciones de marketing.
Artificial Analysis compara Claude Opus 5.5 y GPT-6 Astra en razonamiento, programación, automatización, costo y velocidad.
GPT-6 Astra vs Claude Opus 5.5: benchmarks independientes
Los siguientes resultados comparan ambos modelos en sus configuraciones de máximo esfuerzo de razonamiento.
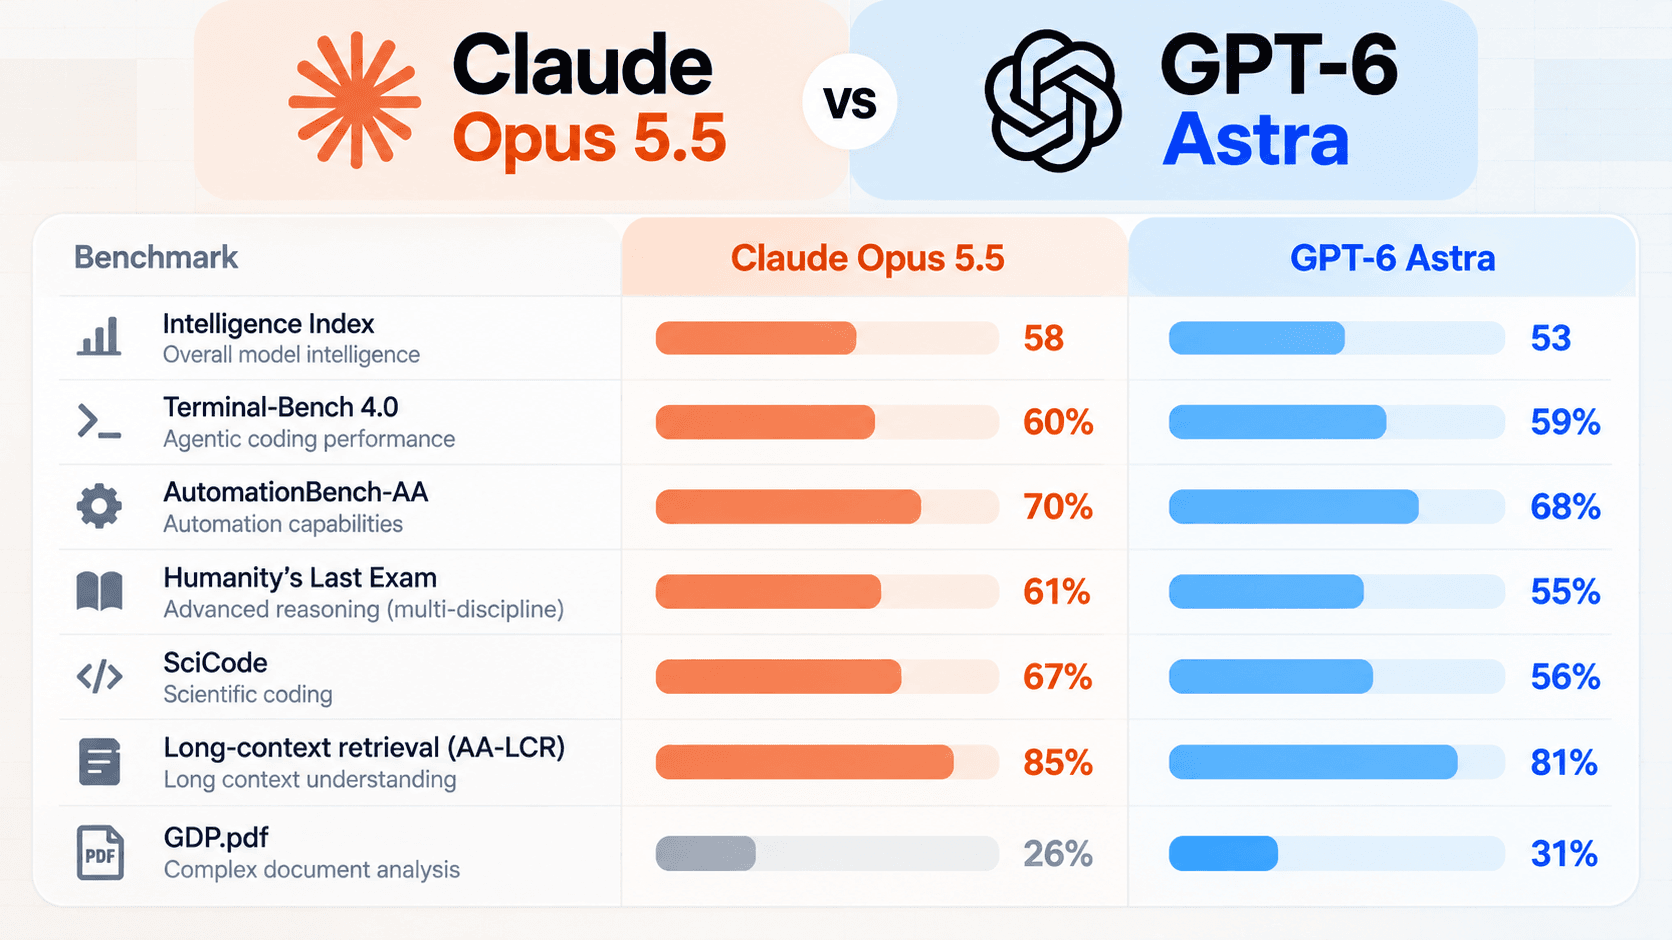
Source: Artificial Analysis — Claude Opus 5.5 vs GPT-6 Astra (Max)
Claude Opus 5.5 lidera en inteligencia general, programación científica y varias evaluaciones avanzadas de razonamiento.
GPT-6 Astra rinde mejor en GDP.pdf, lo que muestra que los resultados no favorecen de forma uniforme a Claude.
Estas puntuaciones también reflejan configuraciones de prueba específicas. Un ajuste distinto del esfuerzo de razonamiento puede cambiar tanto el rendimiento como el costo.
¿Qué significan estos benchmarks para el negocio?
Distintos benchmarks miden distintas capacidades.
- Terminal-Bench 4.0: evalúa la capacidad de un agente de IA para completar tareas usando herramientas basadas en terminal.
- AutomationBench-AA: mide el rendimiento en tareas orientadas a la automatización.
- Humanity's Last Exam: evalúa conocimiento avanzado y razonamiento en varias disciplinas.
- SciCode: evalúa capacidades de programación científica.
- AA-LCR: mide la precisión de recuperación en contextos largos.
Para una agencia de automatización, Terminal-Bench y AutomationBench pueden ser más relevantes que las puntuaciones de conocimiento general.
Para un equipo de investigación empresarial, la recuperación en contexto largo y la precisión factual pueden importar más.
La clave es elegir benchmarks que se parezcan a tu carga de trabajo real.
GPT-6 vs Claude 5.5: velocidad, ventana de contexto y costo
El rendimiento es solo una parte de la decisión.
Artificial Analysis también reporta las siguientes especificaciones y mediciones operativas para los modelos insignia en esfuerzo máximo.
| Metric | Claude Opus 5.5 | GPT-6 Astra |
|---|---|---|
| Context window | 1M tokens | 1M tokens |
| Input price / 1M tokens | $4 | $10 |
| Output price / 1M tokens | $20 | $50 |
| Output speed | 95 tokens/s | 61 tokens/s |
| Average benchmark task cost | $5.98 | $3.26 |
Source: Artificial Analysis — Flagship Model Comparison
Claude Opus 5.5 tiene precios por token más bajos y una generación de salida medida más rápida.
Sin embargo, GPT-6 Astra tiene un menor costo promedio por tarea de benchmark en esta configuración.
¿Por qué?
Los modelos pueden consumir diferentes cantidades de tokens de razonamiento y de salida para resolver el mismo problema. Un modelo con precios por token más altos aún puede costar menos por tarea completada si usa muchos menos tokens.
Para las empresas, esto hace que el costo por tarea aceptada sea más útil que el precio por token por sí solo.
Estas cifras describen el entorno de evaluación de Artificial Analysis, no la latencia ni el costo garantizados en producción.
GPT-6 Sol vs Claude Sonnet 5.5: trabajo empresarial cotidiano
Los modelos insignia no siempre son necesarios para las operaciones diarias.
GPT-6 Sol y Claude Sonnet 5.5 son alternativas relevantes para redacción profesional, programación y trabajo de conocimiento.
La comparación publicada por Anthropic reporta:
| Benchmark | Claude Sonnet 5.5 | GPT-6 Sol |
|---|---|---|
| FrontierCode 1.1 (Main) | 46.2% (Max) | 49.3% |
| GDPval-AA v2.1 | 1,844 | 1,487 |
| AA-Briefcase v1.1 | 1,811 | 1,483 |
| Input price / 1M tokens | $2 | $2 |
| Output price / 1M tokens | $10 | $10 |
Source: Anthropic — Claude Sonnet 5.5 Performance Benchmarks
GPT-6 Sol obtiene una puntuación más alta en el resultado de FrontierCode listado, mientras que Claude Sonnet 5.5 lidera en las evaluaciones de trabajo de conocimiento.
Anthropic también informa que Sonnet 5.5 es más de 30% más rápido que Sonnet 5 y cuesta hasta 30% menos para la mayoría de las cargas de trabajo.
Estas son comparaciones publicadas por Anthropic, y los ajustes de esfuerzo o las condiciones de evaluación pueden diferir entre modelos.
Para las empresas, vale la pena probar ambos modelos en informes, presentaciones, desarrollo de software y otras tareas profesionales recurrentes.
GPT-6 Luna vs Claude Haiku 5.5: tareas de IA de alto volumen
Los modelos más pequeños pueden ofrecer mejores costos para operaciones repetitivas.
Claude Haiku 5.5 y GPT-6 Luna apuntan a cargas de trabajo sensibles al costo donde la velocidad y la eficiencia importan.
Anthropic reporta los siguientes resultados de benchmark:
| Benchmark | Claude Haiku 5.5 | GPT-6 Luna |
|---|---|---|
| Terminal-Bench 4.0 | 39.2% | 16.4% |
| OSWorld 2.1 (offline subset) | 72.4% | 48.9% |
| FrontierCode 1.1 | 46.4% | 42.4% |
| GDPval-AA v2.1 | 1,620 | 1,437 |
| Input price / 1M tokens | $0.10* | $0.10 |
| Output price / 1M tokens | $0.50* | $0.50 |
Source: Anthropic — Claude Haiku 5.5 Benchmarks
Las tarifas listadas de Claude Haiku 5.5 aplican a prompts de hasta 100,000 tokens; los prompts más largos tienen precios distintos.
En las evaluaciones publicadas por Anthropic, Haiku 5.5 supera a Luna en las tareas listadas.
Para empresas que procesan grandes volúmenes de solicitudes de clientes, documentos o datos estructurados, estos resultados hacen que valga la pena probar Haiku 5.5.
Sin embargo, las organizaciones deben verificar si esas ventajas se mantienen para sus propias entradas y requisitos de latencia.
GPT-6 vs Claude 5.5 para casos de uso empresarial
El mejor modelo depende de lo que tu organización necesite lograr.
Programación y desarrollo de software
Ambas familias de modelos ofrecen candidatos sólidos para desarrollo de software.
GPT-6 Astra y Claude Opus 5.5 son relevantes para tareas de programación complejas, mientras que GPT-6.1 Sol y Claude Sonnet 5.5 ofrecen alternativas para el trabajo de desarrollo cotidiano.
Las empresas deben evaluar la calidad del código usando repositorios reales y no solo puntuaciones de benchmarks.
Mide pruebas aprobadas, tiempo de depuración, mantenibilidad y la cantidad de revisiones necesarias.
Para agencias de automatización con IA, estas métricas suelen ser más útiles que la velocidad bruta de generación de código.
Investigación y análisis complejo
Los flujos de investigación requieren información precisa, razonamiento claro e interpretación confiable del material fuente.
Los resultados de Claude Opus 5.5 en razonamiento avanzado y benchmarks de contexto largo lo convierten en un fuerte candidato de evaluación.
GPT-6 Astra también ofrece capacidades para investigación compleja, análisis de datos y tareas profesionales.
Para cualquiera de los dos modelos, las organizaciones deben verificar las afirmaciones importantes con fuentes confiables e incluir revisión humana cuando las decisiones tengan consecuencias significativas.
Documentos de negocio y trabajo de conocimiento
Los equipos usan IA con frecuencia para redactar reportes, analizar documentos, preparar presentaciones y resumir información interna.
Claude Sonnet 5.5 rinde muy bien en benchmarks publicados de trabajo de conocimiento, por lo que vale la pena evaluarlo para operaciones con mucho manejo de documentos.
GPT-6 Sol y GPT-6.1 Sol también son candidatos relevantes para la productividad profesional.
La mejor elección debe basarse en la precisión factual, la calidad del formato, el esfuerzo de edición y la coherencia con los requisitos de la organización.
Automatización con IA y operaciones de alto volumen
Los equipos de automatización necesitan modelos que entreguen resultados aceptables de forma repetida sin costos innecesarios.
Claude Haiku 5.5 y GPT-6 Luna son relevantes para clasificación, extracción estructurada y procesamiento rutinario.
Sin embargo, las puntuaciones de benchmark por sí solas no establecen la confiabilidad en producción.
Los equipos también deben evaluar el manejo de errores, la validación de salida, los límites de velocidad y los requisitos de integración.
Cómo elegir entre GPT-6 y Claude 5.5 para un mejor ROI
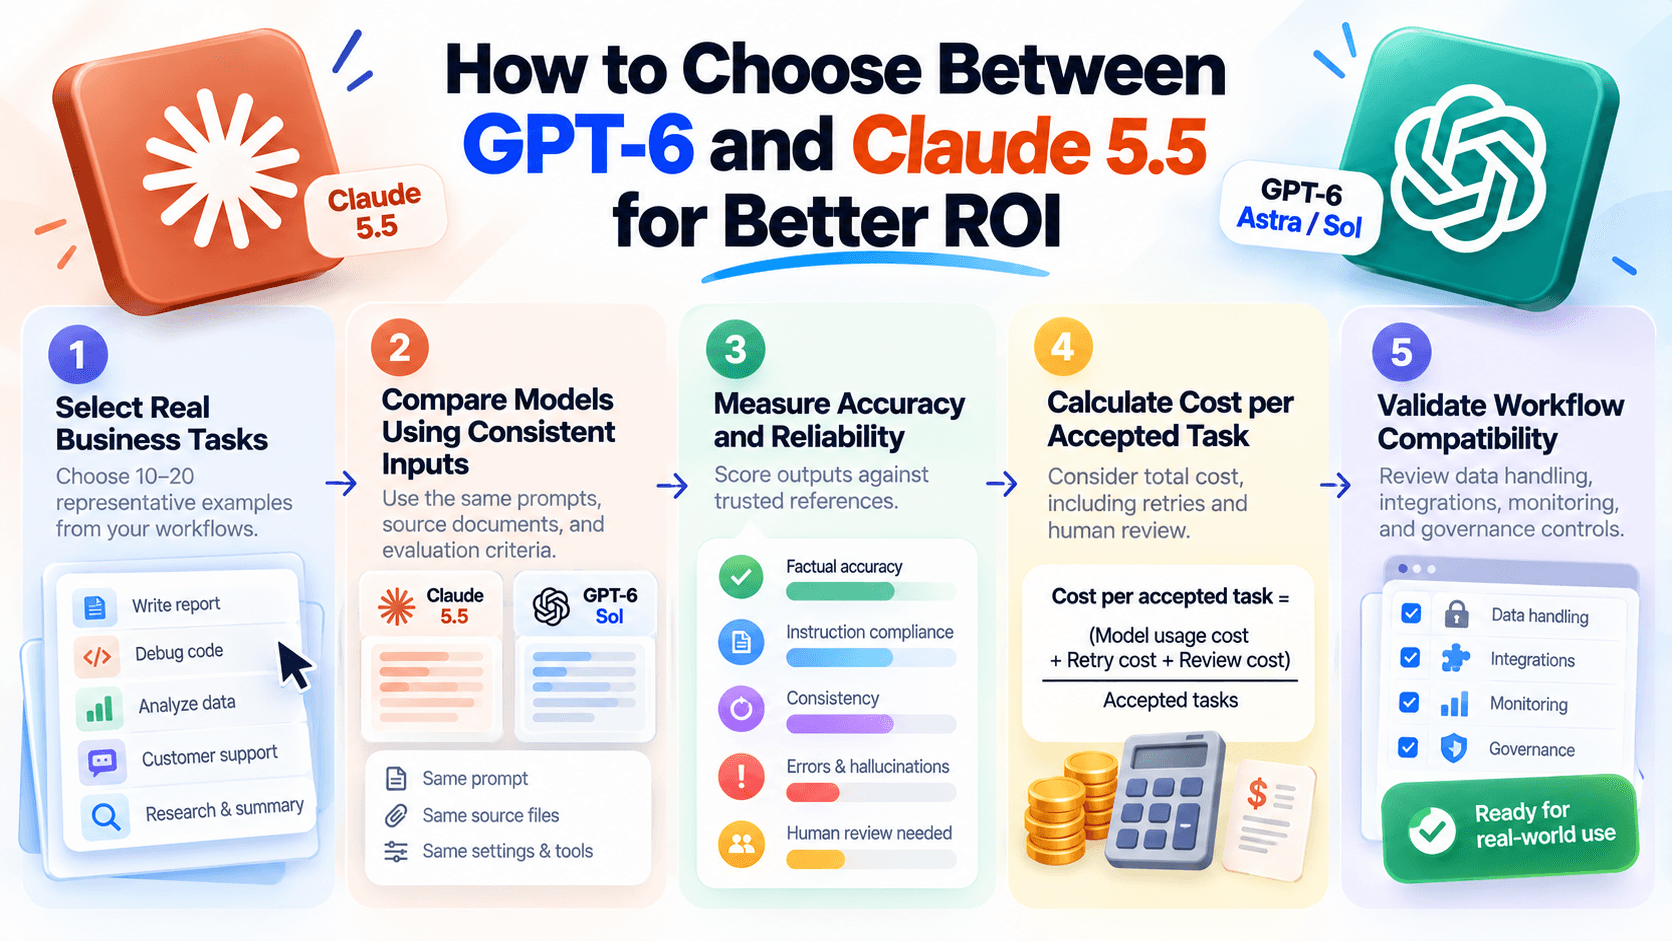
Los líderes de IA deben evaluar los modelos frente a resultados empresariales medibles en lugar de basarse únicamente en rankings públicos.
Un marco práctico incluye cinco pasos.
1. Selecciona tareas reales de negocio
Elige de 10 a 20 ejemplos representativos de tus flujos de trabajo.
Incluye solicitudes sencillas, tareas complejas y casos en los que tu modelo actual falla con frecuencia.
2. Compara modelos usando entradas consistentes
Usa prompts, documentos fuente y criterios de evaluación equivalentes.
Para una comparación justa, documenta los ajustes de esfuerzo de razonamiento y las herramientas disponibles para cada modelo.
3. Mide precisión y confiabilidad
Califica las salidas contra referencias confiables.
Da seguimiento a errores factuales, cumplimiento de instrucciones, consistencia y cantidad de correcciones humanas requeridas.
4. Calcula el costo por tarea aceptada
En lugar de enfocarte solo en los precios por token, calcula:
Costo por tarea aceptada = (Costo de uso del modelo + Costo de reintento + Costo de revisión) ÷ Tareas aceptadas
Esto captura el gasto real de producir resultados utilizables.
5. Valida la compatibilidad con el flujo de trabajo
Antes de implementar un modelo, revisa los requisitos de manejo de datos, integraciones, monitoreo y controles de gobierno.
Un modelo que funciona bien en pruebas aún puede requerir un trabajo de integración significativo antes de ser apto para producción.
Para un marco de selección más amplio, lee El mejor chatbot de IA para negocios: cómo comparar opciones.
Compara modelos de IA en un solo espacio de trabajo con 1min.AI
Probar modelos en interfaces separadas puede hacer que las comparaciones sean más difíciles de gestionar.
1min.AI ofrece un espacio de trabajo unificado para acceder a múltiples modelos de IA compatibles y completar tareas impulsadas por IA.
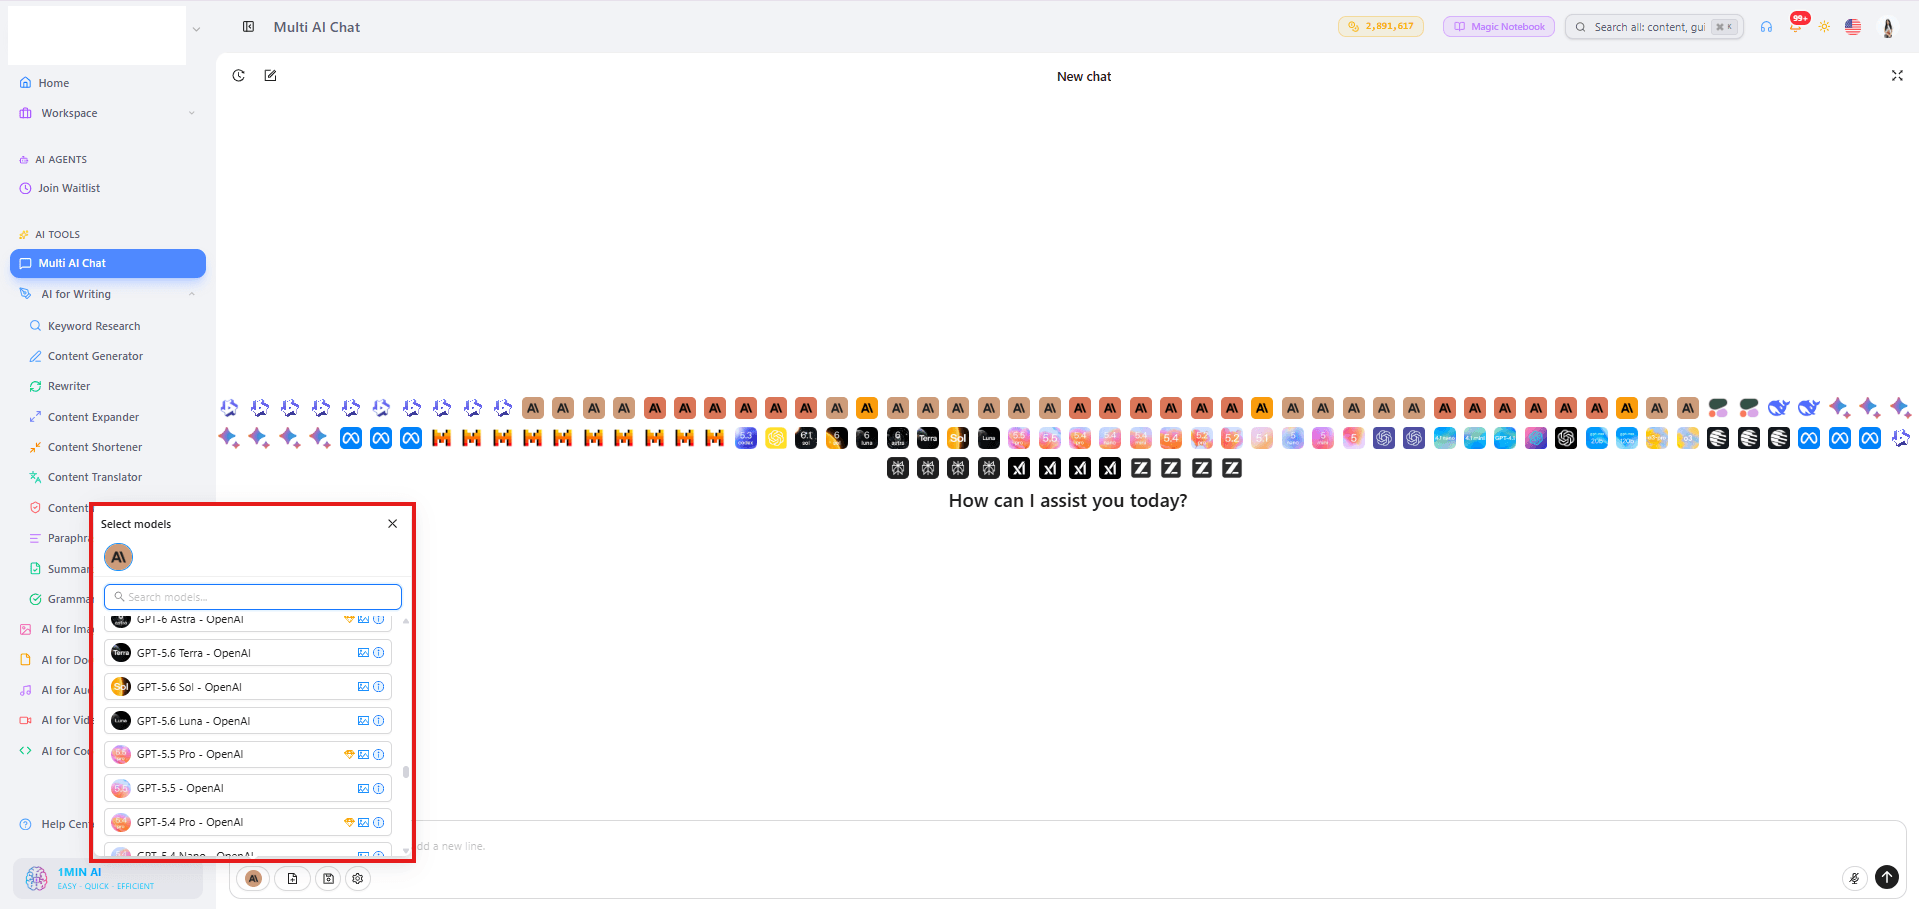
Con Multi AI Chat, los equipos pueden enviar el mismo prompt a modelos compatibles y comparar las respuestas lado a lado.
Mix AI Models permite trabajar con distintos modelos dentro de una conversación, mientras que Document Chat ayuda a los usuarios a interactuar con documentos de negocio.
Para AI Champions y equipos de innovación, estas funciones ofrecen un punto de partida práctico para comparar resultados de modelos antes de comprometerse con una implementación más amplia.
Las variantes específicas de GPT-6 y Claude 5.5 deben verificarse en la selección actual de modelos de 1min.AI antes de probarlas.
Un espacio de trabajo multimodelo puede simplificar la evaluación, pero la implementación en producción sigue requiriendo integraciones adecuadas, revisiones de seguridad y controles operativos.
Veredicto final: ¿GPT-6 o Claude 5.5?
Claude Opus 5.5 supera a GPT-6 Astra en varios benchmarks independientes de inteligencia y programación. Claude Sonnet 5.5 y Haiku 5.5 también muestran resultados sólidos en las comparaciones publicadas por Anthropic sobre trabajo profesional y modelos pequeños.
Sin embargo, los modelos GPT-6 siguen siendo competitivos, y GPT-6 Astra demuestra cómo precios por token más altos pueden coexistir con costos más bajos por tarea de benchmark.
Para las empresas, no hay un ganador universal.
Elige el modelo que ofrezca la precisión, la confiabilidad y la compatibilidad con el flujo de trabajo requeridas al menor costo total sostenible.
En lugar de cambiar de proveedor por el último lanzamiento, prueba varios modelos con cargas de trabajo reales y mide los resultados.
Explora 1min.AI para comparar modelos de IA compatibles en un solo espacio de trabajo y encontrar la opción ideal para tu negocio.
Preguntas frecuentes
¿GPT-6 es mejor que Claude 5.5?
No en todos los benchmarks. Claude Opus 5.5 lidera en varias evaluaciones independientes de inteligencia y programación, mientras que GPT-6 Astra rinde mejor en ciertas pruebas y puede tener costos más bajos por tarea de benchmark.
¿Cuál es mejor para programar: GPT-6 o Claude 5.5?
Ambos ofrecen modelos competitivos para programación. Claude Opus 5.5 rinde muy bien en Terminal-Bench 4.0, mientras que GPT-6 Sol supera a Claude Sonnet 5.5 en la comparación FrontierCode listada. Los resultados dependen del nivel del modelo, el ajuste de esfuerzo y la tarea de programación.
¿Cuál es más barato: GPT-6 o Claude 5.5?
Depende del modelo y la carga de trabajo. Claude Opus 5.5 tiene precios por token listados más bajos que GPT-6 Astra, pero este último puede usar menos tokens por tarea. Compara los costos totales por tarea aceptada y no solo los precios por token.
¿Claude 5.5 es mejor para documentos de negocio?
Claude Sonnet 5.5 rinde muy bien en benchmarks publicados de trabajo de conocimiento. Sin embargo, las empresas deben compararlo con los modelos GPT-6 usando sus propios documentos y estándares de evaluación.
¿Puedo comparar GPT-6 y Claude 5.5 con 1min.AI?
1min.AI permite comparar respuestas de varios modelos de IA disponibles mediante Multi AI Chat. Revisa la lista actual de modelos de la plataforma para confirmar la disponibilidad de las variantes específicas de GPT-6 y Claude 5.5 que quieras evaluar.
- #Informational
Alternativas
Descubre las mejores alternativas a 1minAI y compara características, precios y casos de uso.
1min.AI vs OpenRouter
1min.AI vs. OpenRouter: Compara el producto de creación de IA listo para usar con la herramienta técnica de API. Descubre si necesitas un estudio creativo sin código o una infraestructura para desarrolladores.
 Ngoc Hong
1min. AI vs Dola AI
¿Buscas una alternativa a Dola AI? Compara 1min.AI vs Dola AI en generación de video, planes gratis, precios y privacidad para elegir la app de IA adecuada.
Ngoc Hong
1minAI vs Hix AI
Compara 5 alternativas a HIX AI para chat con IA, investigación, redacción, imágenes, video, precios y flujos de trabajo de IA flexibles.
Ngoc HongHerramientas de IA
Descubre las mejores herramientas de IA para aumentar la productividad, la creatividad y el trabajo diario.
Un producto, 10 creativos UGC: cómo la IA facilita la prueba de contenido
Crea UGC más auténtico con un generador de videos UGC con IA, prueba más ángulos creativos y escala contenido de afiliados sin filmar cada versión.
 Lien Anh Vu
Crea contenido animado constante en solo unos pasos
Crea videos animados para TikTok y Reels en 3 pasos simples con 1min.AI, desde investigar ideas hasta personajes y videos animados.
Lien Anh Vu
Las 4 mejores herramientas de IA asequibles para fundadores de startups
Descubre las 4 mejores herramientas de IA asequibles para fundadores de startups para validar ideas, crear productos, generar contenido y lanzar más rápido sin gastar de más.
 Tram Ta
Funciones de IA
Funciones de IA completas que agilizan los flujos de trabajo, mejoran la eficiencia y permiten a los equipos lograr más.
Un producto, 10 creativos UGC: cómo la IA facilita la prueba de contenido
Crea UGC más auténtico con un generador de videos UGC con IA, prueba más ángulos creativos y escala contenido de afiliados sin filmar cada versión.
Lien Anh VuCrea contenido animado constante en solo unos pasos
Crea videos animados para TikTok y Reels en 3 pasos simples con 1min.AI, desde investigar ideas hasta personajes y videos animados.
Lien Anh Vu
1minAI: Corrector gramatical de IA gratis
Revisa la gramática gratis con el corrector gramatical de IA de 1minAI. Encuentra errores de gramática, ortografía y redacción, mejora la claridad y pule tu contenido en segundos.
Tram TaCasos de uso de IA
Una colección curada de casos de uso de IA para negocios, productividad y aplicaciones específicas por industria.
Un producto, 10 creativos UGC: cómo la IA facilita la prueba de contenido
Crea UGC más auténtico con un generador de videos UGC con IA, prueba más ángulos creativos y escala contenido de afiliados sin filmar cada versión.
Lien Anh VuCrea contenido animado constante en solo unos pasos
Crea videos animados para TikTok y Reels en 3 pasos simples con 1min.AI, desde investigar ideas hasta personajes y videos animados.
Lien Anh Vu
Mejor hora para publicar en Instagram: una guía práctica para mejorar la interacción
Descubre la mejor hora para publicar en Instagram, incluidos los mejores días y horas para distintas audiencias, además de consejos para encontrar el horario ideal de publicación para tu cuenta.
Tram TaTutoriales de IA
Aprende a usar la IA con tutoriales prácticos paso a paso.
Crea contenido animado constante en solo unos pasos
Crea videos animados para TikTok y Reels en 3 pasos simples con 1min.AI, desde investigar ideas hasta personajes y videos animados.
Lien Anh Vu
Ofertas de herramientas de IA para Black Friday en 2026
Descubre qué ofrecen las ofertas de herramientas de IA para Black Friday 2026. Averigua cómo asegurar la oferta de por vida de 1min.AI a través de AppSumo, Dealify y Stack Social, y verifica en Trustpilot, Slashdot y Software Advice.
 Hang Nguyen
Consistencia de producto de imagen a video con IA y Seedance para detener la deformación y escalar reseñas de productos
Detén la deformación de los logos con consistencia de producto de imagen a video con IA y genera hoy videos de reseñas con calidad de estudio en 1min.AI.
Lien Anh VuGuías de IA
Aprende IA más rápido con guías prácticas, ejemplos del mundo real y mejores prácticas aplicables.
Crea contenido animado constante en solo unos pasos
Crea videos animados para TikTok y Reels en 3 pasos simples con 1min.AI, desde investigar ideas hasta personajes y videos animados.
Lien Anh Vu
Compra con seguridad herramientas de IA en línea: Guía de Black Friday 2026
Descubre cómo encontrar y asegurar las mejores ofertas de Black Friday en IA en línea. Aprende estrategias expertas para evitar estafas, combatir la fatiga de suscripciones y verificar software.
Hang NguyenConsistencia de producto de imagen a video con IA y Seedance para detener la deformación y escalar reseñas de productos
Detén la deformación de los logos con consistencia de producto de imagen a video con IA y genera hoy videos de reseñas con calidad de estudio en 1min.AI.
Lien Anh VuSoluciones de IA
Explore las mejores soluciones de IA para automatización, codificación, investigación, productividad, atención al cliente, marketing y flujos de trabajo empresariales.
Un producto, 10 creativos UGC: cómo la IA facilita la prueba de contenido
Crea UGC más auténtico con un generador de videos UGC con IA, prueba más ángulos creativos y escala contenido de afiliados sin filmar cada versión.
Lien Anh VuCrea contenido animado constante en solo unos pasos
Crea videos animados para TikTok y Reels en 3 pasos simples con 1min.AI, desde investigar ideas hasta personajes y videos animados.
Lien Anh Vu
Generador Gratis de Tatuajes con IA: Diseños Personalizados
Convierte cualquier idea en un diseño de tatuaje personalizado con el generador gratis de tatuajes con IA de 1min.AI. Describe tu idea, elige un estilo y descarga en segundos.
 Trang Tran
Modelos de IA
Explora los modelos de IA líderes del mundo en un solo lugar.
Un producto, 10 creativos UGC: cómo la IA facilita la prueba de contenido
Crea UGC más auténtico con un generador de videos UGC con IA, prueba más ángulos creativos y escala contenido de afiliados sin filmar cada versión.
Lien Anh VuCrea contenido animado constante en solo unos pasos
Crea videos animados para TikTok y Reels en 3 pasos simples con 1min.AI, desde investigar ideas hasta personajes y videos animados.
Lien Anh VuConsistencia de producto de imagen a video con IA y Seedance para detener la deformación y escalar reseñas de productos
Detén la deformación de los logos con consistencia de producto de imagen a video con IA y genera hoy videos de reseñas con calidad de estudio en 1min.AI.
Lien Anh VuComparaciones de IA
Compara herramientas, modelos y plataformas de IA para encontrar la que mejor se adapte a tus necesidades.
Kling AI vs Veo 3: ¿qué modelo gana?
Kling AI vs Veo 3: compara movimiento, audio nativo, precios y planes gratis para ver qué generador de video con IA gana para tu proyecto. Prueba ambos en 1min.AI.
Trang TranConsistencia de producto de imagen a video con IA y Seedance para detener la deformación y escalar reseñas de productos
Detén la deformación de los logos con consistencia de producto de imagen a video con IA y genera hoy videos de reseñas con calidad de estudio en 1min.AI.
Lien Anh Vu
Comparación DeepSeek V4 Pro vs Flash
Compara métricas de DeepSeek V4 Pro y DeepSeek V4 Flash. Optimiza tus aplicaciones agentivas y mejora la verificación de hechos de IA en 1min.ai hoy.
Ngoc HongIntegraciones de IA
Integra la IA de forma fluida con las herramientas que ya usas para automatizar tareas y aumentar la productividad.
Cómo usar un generador de video de moda con IA para Fashion Week 2026
Convierte ideas de Fashion Week 2026 en videos de moda impactantes con IA. Aprende a idear, crear visuales y transformar imágenes en videos con un flujo de trabajo simple.
Lien Anh Vu
POV: Tienes más de 10 publicaciones que hacer cada día
Aprende a crear un flujo de trabajo de contenido con IA que ayuda a los creadores de contenido a producir más de 10 publicaciones al día más rápido con lluvia de ideas, generación de imágenes y creación de contenido con IA.
Lien Anh Vu
Deja de Cambiar entre Apps de IA: Cómo la Integración de IA Transforma el Employer Branding
Descubre cómo la integración de IA ayuda a los equipos de RR. HH. a optimizar el employer branding al combinar redacción con IA, documentos, imágenes, video y múltiples modelos de IA en un solo espacio de trabajo.
Tram TaIA para Industrias
Encuentre las mejores herramientas y flujos de trabajo de IA para atención médica, finanzas, educación, legal, manufactura, comercio minorista, bienes raíces y más.
Generador gratuito de descripciones de producto con IA
Escribe descripciones de producto que vendan en minutos. Usa este generador gratuito de descripciones de producto con IA para convertir detalles o una foto en texto alineado con tu marca. Prueba 1min.AI.
Trang Tran
Las mejores herramientas de productividad empresarial para startups para maximizar las ganancias | 1minAI
Descubre las mejores herramientas de productividad empresarial para startups para ahorrar tiempo, optimizar flujos de trabajo, reducir tareas repetitivas y apoyar un crecimiento rentable con IA.
Tram Ta
La mejor herramienta de IA para marketing de contenidos |1minAI
¿Buscas la mejor herramienta de IA para marketing de contenidos? Mira cómo 1minAI ayuda a los especialistas en marketing a investigar, escribir, reutilizar, crear elementos visuales y escalar contenido desde un solo espacio de trabajo de IA.
Tram TaAgentes de IA
Descubre y ejecuta agentes de IA para automatizar tareas en tu trabajo y vida diaria.
1minAI: Corrector gramatical de IA gratis
Revisa la gramática gratis con el corrector gramatical de IA de 1minAI. Encuentra errores de gramática, ortografía y redacción, mejora la claridad y pule tu contenido en segundos.
Tram Ta
Agentes de IA para Facebook
Usa un Agente de IA para Facebook para crear contenido, generar imágenes, programar publicaciones y publicar desde tus documentos y conversaciones.
Ngoc Hong
Agente de IA vs Asistente de IA: ¿Cuál realmente les ahorra más tiempo a los diseñadores?
Conoce la diferencia entre Agente de IA vs Asistente de IA y descubre qué solución ayuda a los diseñadores a automatizar tareas repetitivas, reducir revisiones y ahorrar más tiempo.
Lien Anh VuFlujos de trabajo de IA
Explore flujos de trabajo de IA listos para usar para productividad, marketing, ventas, soporte y más.
Un producto, 10 creativos UGC: cómo la IA facilita la prueba de contenido
Crea UGC más auténtico con un generador de videos UGC con IA, prueba más ángulos creativos y escala contenido de afiliados sin filmar cada versión.
Lien Anh VuCrea contenido animado constante en solo unos pasos
Crea videos animados para TikTok y Reels en 3 pasos simples con 1min.AI, desde investigar ideas hasta personajes y videos animados.
Lien Anh VuCómo usar un generador de video de moda con IA para Fashion Week 2026
Convierte ideas de Fashion Week 2026 en videos de moda impactantes con IA. Aprende a idear, crear visuales y transformar imágenes en videos con un flujo de trabajo simple.
Lien Anh VuBoletín
Innovaciones semanales en IA con 1minAI
🔮 Innovaciones semanales de IA #141: Seedance 2.5 y Stable Audio 3: IA de próxima generación
Explora Seedance 2.0, 2.5 y Stable Audio 3 de StabilityAI en 1min.ai. Genera audio de calidad de estudio y movimiento sincronizado con IA generativa de próxima generación.
Hang Nguyen
🔮 Weekly AI Innovations #121: Ideogram 3.0 y Claude Opus 4.7 ya están disponibles en 1min.ai
Ideogram 3.0 y Claude Opus 4.7 ya están disponibles en 1min.ai. Genera tipografía de imagen impecable y textos avanzados en una sola plataforma.
 Uyen Hoang
🔮 Weekly AI Innovations #134: Experimenta Qwen gratis en AI Chat; actualización de las series 3.7 y 3.6
¿Buscas un asistente de IA potente y gratis? Explora las últimas series Qwen 3.7 y 3.6 en 1min.ai. ¡Disfruta hoy mismo de chat de IA rápido y preciso sin costo!
Hang Nguyen