GPT-6 مقابل Claude 5.5: أيهما الأفضل للأعمال؟

Ngoc Hong
16 أكتوبر 2026
قارن بين GPT-6 وClaude 5.5 للترميز والبحث وسير عمل الأعمال. اكتشف نموذج الذكاء الاصطناعي الأنسب لاحتياجات فريقك وميزانيتك وأهداف الإنتاجية.
GPT-6 مقابل Claude 5.5: أيهما الأفضل للأعمال؟
يُعدّ GPT-6 مقابل Claude 5.5 مقارنة مهمة للشركات التي تقرر أي نماذج الذكاء الاصطناعي تعتمد. فكل من OpenAI وAnthropic يقدمان نماذج قوية للترميز والبحث وتحليل المستندات والمهام المهنية المعقدة. لكن نتائج الاختبارات المعيارية الأقوى لا تترجم دائمًا إلى نتائج أعمال أفضل.
بالنسبة لقادة الذكاء الاصطناعي، وفرق الابتكار، ووكالات الأتمتة، ينبغي أن يراعي القرار الأداء والموثوقية والتكلفة وتوافق سير العمل.
يقارن هذا الدليل بين GPT-6 وClaude 5.5 باستخدام الاختبارات المعيارية المنشورة ومواصفات النماذج الرسمية وحالات الاستخدام العملية في الأعمال.
GPT-6 مقابل Claude 5.5: أهم الفروقات في لمحة
GPT-6 وClaude 5.5 هما عائلتا نماذج وليستا نموذجين فرديين. وتضم كل منهما خيارات بمستويات مختلفة من التعقيد والتكلفة.
| الفئة | عائلة GPT-6 | عائلة Claude 5.5 |
|---|---|---|
| المطوّر | OpenAI | Anthropic |
| النموذج الرائد | GPT-6 Astra | Claude Opus 5.5 |
| العمل المهني | GPT-6.1 Sol | Claude Sonnet 5.5 |
| النموذج الاقتصادي | GPT-6 Luna | Claude Haiku 5.5 |
| أبرز نقاط القوة للمراجعة | التفكير المتقدم، البرمجة، استخدام الحاسوب | التحليل المعقد، البرمجة، العمل المعرفي |
| الاعتبار التجاري الرئيسي | القدرة مقابل تكلفة المهمة | الجودة والكفاءة وملاءمة عبء العمل |
تضع OpenAI نموذج Astra للمهام الأكثر تطلبًا، وGPT-6.1 Sol لقدرات قريبة من الرائد وبسعر أقل. وتضع Anthropic نموذج Opus للحكم المعقد، وSonnet للعمل المهني اليومي، وHaiku للعمليات عالية الحجم.
الخلاصة السريعة: يتفوق Claude Opus 5.5 على GPT-6 Astra في عدة اختبارات معيارية مستقلة للذكاء والبرمجة. ومع ذلك، يستطيع GPT-6 Astra إنهاء بعض أحمال الاختبار بعدد أقل من الرموز وتكلفة إجمالية أقل للمهمة.
يعتمد اختيار الأعمال الأفضل على المقايضات الأكثر أهمية.
المصادر: دليل نموذج GPT-6 من OpenAI | Claude Sonnet 5.5 من Anthropic
اختبارات GPT-6 مقابل Claude 5.5: أيهما يقدم أداءً أفضل؟
تساعد الاختبارات المعيارية المستقلة الشركات على تقييم قدرات النماذج بعيدًا عن الادعاءات التسويقية.
تقارن Artificial Analysis بين Claude Opus 5.5 وGPT-6 Astra عبر الاستدلال والبرمجة والأتمتة والتكلفة والسرعة.
GPT-6 Astra مقابل Claude Opus 5.5: اختبارات معيارية مستقلة
تقارن النتائج التالية بين النموذجين في أقصى إعدادات جهد للاستدلال.
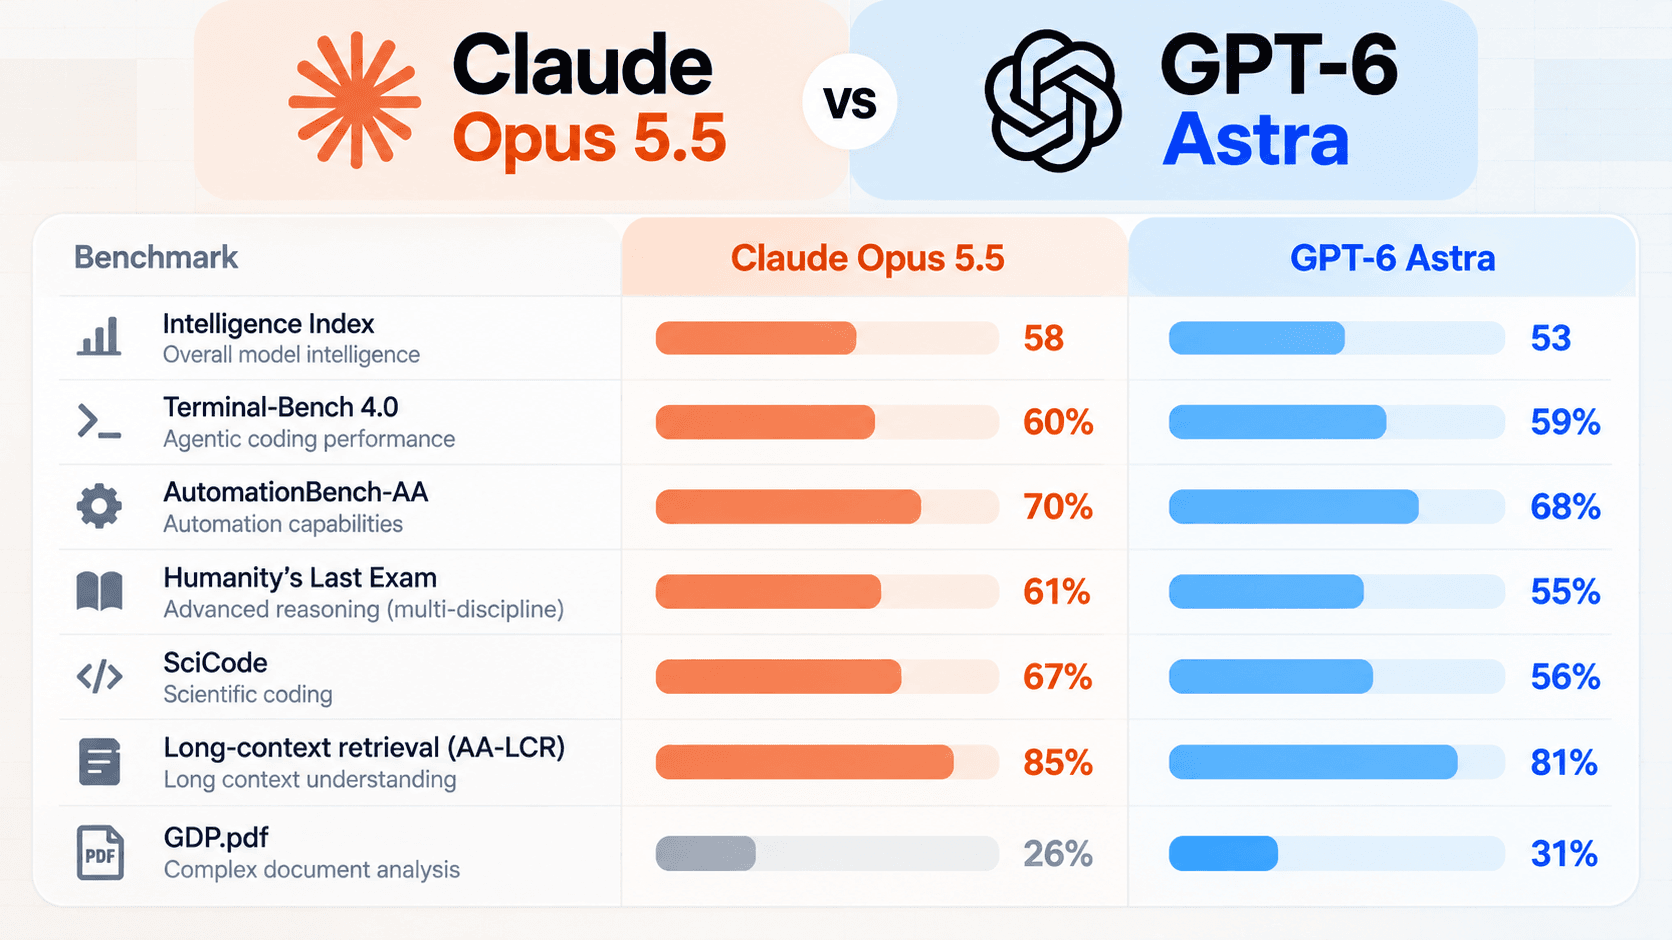
المصدر: Artificial Analysis — Claude Opus 5.5 vs GPT-6 Astra (Max)
يتصدر Claude Opus 5.5 في الذكاء العام والبرمجة العلمية وعدة تقييمات متقدمة للاستدلال.
ويؤدي GPT-6 Astra بشكل أفضل في GDP.pdf، ما يوضح أن النتائج ليست كلها لصالح Claude.
كما تعكس هذه الدرجات إعدادات اختبار محددة. ويمكن لإعداد مختلف لجهد الاستدلال أن يغيّر الأداء والتكلفة معًا.
ماذا تعني هذه الاختبارات للأعمال؟
تقيس الاختبارات المختلفة قدرات مختلفة.
- Terminal-Bench 4.0: يقيس قدرة وكيل الذكاء الاصطناعي على إنجاز المهام باستخدام أدوات قائمة على الطرفية.
- AutomationBench-AA: يقيس الأداء في المهام الموجهة نحو الأتمتة.
- Humanity's Last Exam: يختبر المعرفة المتقدمة والاستدلال عبر التخصصات.
- SciCode: يقيم قدرات البرمجة العلمية.
- AA-LCR: يقيس دقة الاسترجاع عبر السياقات الطويلة.
بالنسبة لوكالة أتمتة، قد تكون Terminal-Bench وAutomationBench أكثر صلة من درجات المعرفة العامة.
وبالنسبة لفريق أبحاث مؤسسي، قد يكون الاسترجاع طويل السياق والدقة الواقعية أكثر أهمية.
المهم هو اختيار الاختبارات التي تشبه عبء العمل الفعلي لديك.
GPT-6 مقابل Claude 5.5: السرعة، نافذة السياق، والتكلفة
الأداء ليس سوى جزء من القرار.
كما تعرض Artificial Analysis المواصفات التالية والقياسات التشغيلية للنماذج الرائدة عند أقصى جهد.
| المقياس | Claude Opus 5.5 | GPT-6 Astra |
|---|---|---|
| نافذة السياق | 1M tokens | 1M tokens |
| سعر الإدخال / 1M tokens | $4 | $10 |
| سعر الإخراج / 1M tokens | $20 | $50 |
| سرعة الإخراج | 95 tokens/s | 61 tokens/s |
| متوسط تكلفة المهمة المعيارية | $5.98 | $3.26 |
المصدر: Artificial Analysis — Flagship Model Comparison
يمتلك Claude Opus 5.5 أسعار رموز أقل وإنتاجية إخراج أسرع مقاسة.
ومع ذلك، يتمتع GPT-6 Astra بمتوسط تكلفة أقل لكل مهمة معيارية في هذا الإعداد.
لماذا؟
يمكن للنماذج أن تستهلك أعدادًا مختلفة من رموز الاستدلال والإخراج لحل المشكلة نفسها. وقد يكون النموذج ذو الأسعار الأعلى لكل رمز أقل تكلفة لكل مهمة مكتملة إذا استخدم عددًا أقل بكثير من الرموز.
بالنسبة للشركات، يجعل هذا التكلفة لكل مهمة مقبولة أكثر فائدة من تسعير الرموز وحده.
هذه الأرقام تصف بيئة تقييم Artificial Analysis، وليست زمن استجابة أو تكلفة مضمونة في الإنتاج.
GPT-6 Sol مقابل Claude Sonnet 5.5: العمل اليومي في الأعمال
النماذج الرائدة ليست ضرورية دائمًا للعمليات اليومية.
يُعد GPT-6 Sol وClaude Sonnet 5.5 بدائل مهمة للكتابة المهنية والبرمجة والعمل المعرفي.
تشير المقارنة المنشورة من Anthropic إلى ما يلي:
| الاختبار المعياري | Claude Sonnet 5.5 | GPT-6 Sol |
|---|---|---|
| FrontierCode 1.1 (Main) | 46.2% (Max) | 49.3% |
| GDPval-AA v2.1 | 1,844 | 1,487 |
| AA-Briefcase v1.1 | 1,811 | 1,483 |
| سعر الإدخال / 1M tokens | $2 | $2 |
| سعر الإخراج / 1M tokens | $10 | $10 |
المصدر: Anthropic — Claude Sonnet 5.5 Performance Benchmarks
يسجل GPT-6 Sol نتيجة أعلى في اختبار FrontierCode المذكور، بينما يتقدم Claude Sonnet 5.5 في تقييمات العمل المعرفي.
كما تشير Anthropic إلى أن Sonnet 5.5 أسرع بأكثر من 30% من Sonnet 5 وأقل تكلفة بما يصل إلى 30% في معظم أحمال العمل.
هذه مقارنات منشورة من Anthropic، وقد تختلف إعدادات الجهد أو شروط التقييم بين النماذج.
بالنسبة للشركات، يستحق كلا النموذجين الاختبار على التقارير والعروض التقديمية وتطوير البرمجيات وغيرها من المهام المهنية المتكررة.
GPT-6 Luna مقابل Claude Haiku 5.5: مهام الذكاء الاصطناعي عالية الحجم
يمكن للنماذج الأصغر أن تقدم اقتصاديات أفضل للعمليات المتكررة.
يستهدف Claude Haiku 5.5 وGPT-6 Luna أحمال العمل الحساسة للتكلفة حيث تهم السرعة والكفاءة.
تورد Anthropic نتائج الاختبارات التالية:
| الاختبار المعياري | Claude Haiku 5.5 | GPT-6 Luna |
|---|---|---|
| Terminal-Bench 4.0 | 39.2% | 16.4% |
| OSWorld 2.1 (offline subset) | 72.4% | 48.9% |
| FrontierCode 1.1 | 46.4% | 42.4% |
| GDPval-AA v2.1 | 1,620 | 1,437 |
| سعر الإدخال / 1M tokens | $0.10* | $0.10 |
| سعر الإخراج / 1M tokens | $0.50* | $0.50 |
المصدر: Anthropic — Claude Haiku 5.5 Benchmarks
تنطبق الأسعار المذكورة لـ Claude Haiku 5.5 على المطالبات حتى 100,000 رمز؛ أما المطالبات الأطول فلها تسعير مختلف.
في التقييمات المنشورة من Anthropic، يتفوق Haiku 5.5 على Luna عبر المهام المذكورة.
بالنسبة للشركات التي تعالج كميات كبيرة من طلبات العملاء أو المستندات أو البيانات المنظمة، تجعل هذه النتائج Haiku 5.5 جديرًا بالاختبار.
ومع ذلك، يجب على المؤسسات التحقق مما إذا كانت هذه المزايا تتحقق مع مدخلاتها ومتطلبات زمن الاستجابة الخاصة بها.
GPT-6 مقابل Claude 5.5 لحالات الاستخدام التجاري
يعتمد أفضل نموذج على ما تحتاج مؤسستك إلى إنجازه.
البرمجة وتطوير البرمجيات
تقدم كلتا عائلتي النماذج خيارات قوية لتطوير البرمجيات.
يُعد GPT-6 Astra وClaude Opus 5.5 مناسبين لمهام البرمجة المعقدة، بينما يوفر GPT-6.1 Sol وClaude Sonnet 5.5 بدائل للعمل التطويري اليومي.
ينبغي على الشركات تقييم جودة الكود باستخدام مستودعات فعلية بدلًا من الاعتماد على نتائج الاختبارات المعيارية وحدها.
قِس الاختبارات الناجحة، ووقت تصحيح الأخطاء، وقابلية الصيانة، وعدد المراجعات المطلوبة.
بالنسبة لوكالات أتمتة الذكاء الاصطناعي، غالبًا ما تكون هذه المقاييس أكثر فائدة من سرعة توليد الكود الخام.
البحث والتحليل المعقد
تتطلب سير عمل البحث معلومات دقيقة واستدلالًا واضحًا وتفسيرًا موثوقًا للمواد المصدرية.
تجعل نتائج Claude Opus 5.5 في الاستدلال المتقدم والاختبارات ذات السياق الطويل منه مرشحًا قويًا للتقييم.
كما يوفر GPT-6 Astra قدرات للبحث المعقد وتحليل البيانات والمهام المهنية.
في كلا النموذجين، ينبغي للمؤسسات التحقق من الادعاءات المهمة عبر مصادر موثوقة وإدراج مراجعة بشرية عندما تحمل القرارات عواقب كبيرة.
المستندات التجارية والعمل المعرفي
تستخدم الفرق الذكاء الاصطناعي كثيرًا لصياغة التقارير وتحليل المستندات وإعداد العروض التقديمية وتلخيص المعلومات الداخلية.
يؤدي Claude Sonnet 5.5 أداءً قويًا في اختبارات العمل المعرفي المنشورة، ما يجعله جديرًا بالتقييم في العمليات كثيفة المستندات.
كما يُعد GPT-6 Sol وGPT-6.1 Sol مرشحين مهمين للإنتاجية المهنية.
ينبغي أن يستند الاختيار الأفضل إلى الدقة الواقعية وجودة التنسيق وجهد التحرير والاتساق مع متطلبات المؤسسة.
أتمتة الذكاء الاصطناعي والعمليات عالية الحجم
تحتاج فرق الأتمتة إلى نماذج تقدم نتائج مقبولة بشكل متكرر دون تكاليف غير ضرورية.
يُعد Claude Haiku 5.5 وGPT-6 Luna مناسبين للتصنيف والاستخراج المنظم والمعالجة الروتينية.
لكن نتائج الاختبارات المعيارية وحدها لا تثبت موثوقية الإنتاج.
يجب على الفرق أيضًا تقييم معالجة الأخطاء والتحقق من الإخراج وحدود المعدل ومتطلبات التكامل.
كيف تختار بين GPT-6 وClaude 5.5 لتحقيق عائد أفضل على الاستثمار
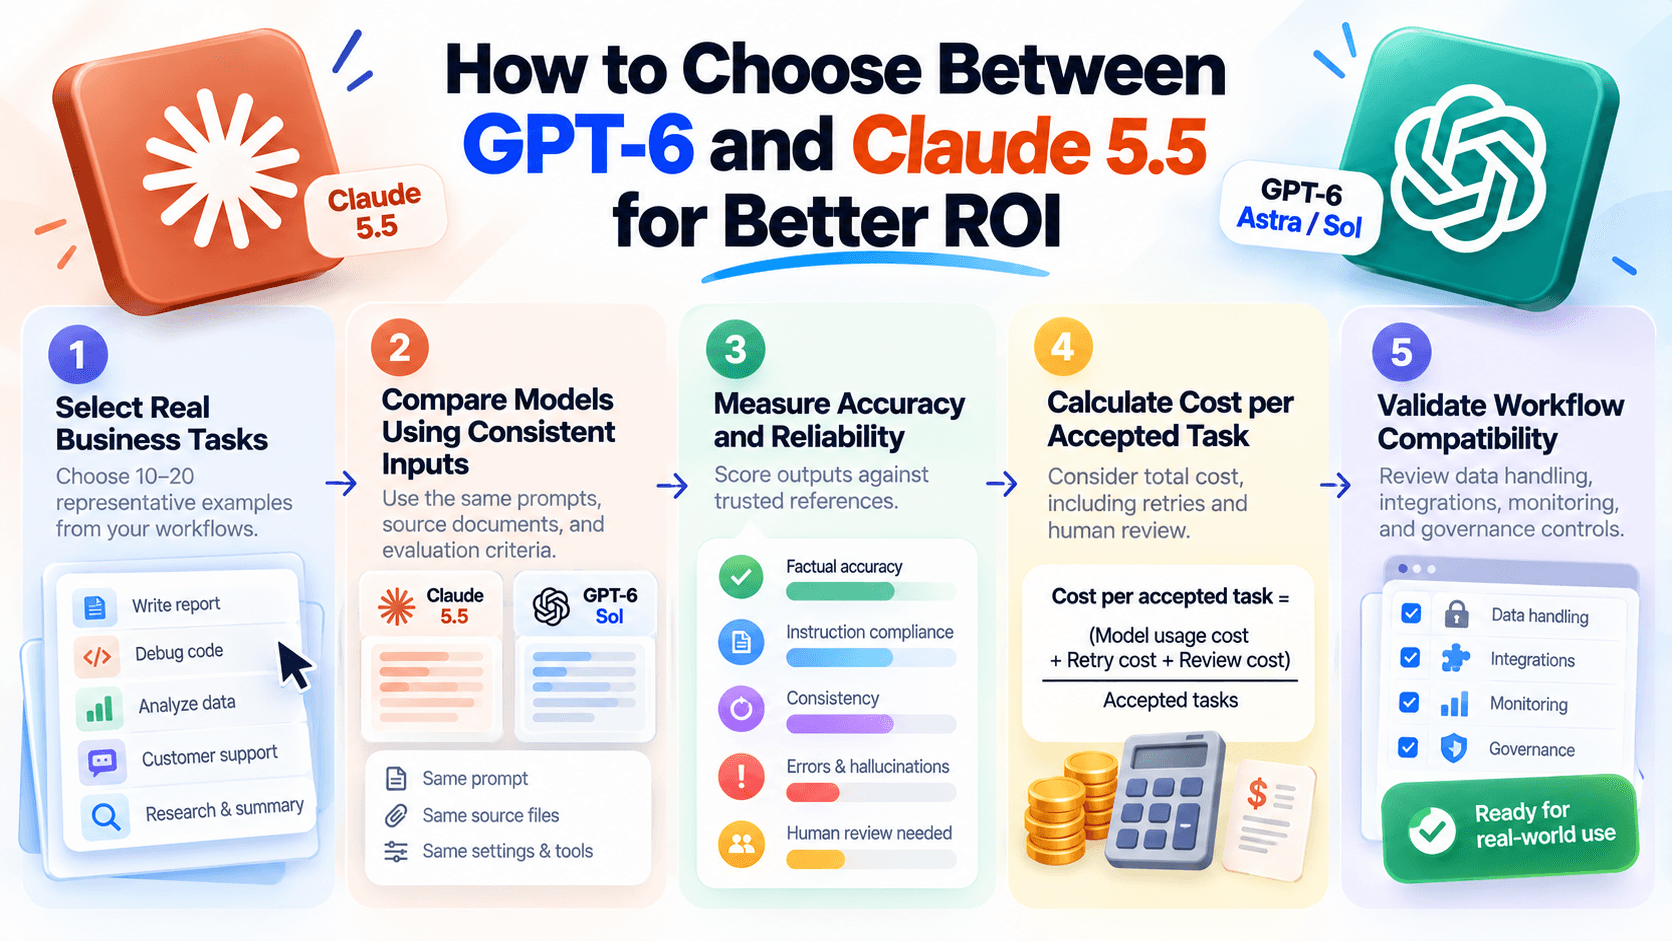
ينبغي لقادة الذكاء الاصطناعي تقييم النماذج وفق نتائج أعمال قابلة للقياس بدلًا من الاعتماد فقط على التصنيفات العامة.
يتضمن الإطار العملي خمس خطوات.
1. اختر مهام أعمال حقيقية
اختر 10–20 مثالًا ممثلًا من سير العمل لديك.
ضمّن الطلبات المباشرة والمهام المعقدة والحالات التي يفشل فيها النموذج الحالي كثيرًا.
2. قارن النماذج باستخدام مدخلات متسقة
استخدم مطالبات و مستندات مصدرية ومعايير تقييم متكافئة.
وللمقارنة العادلة، وثّق إعدادات جهد الاستدلال والأدوات المتاحة لكل نموذج.
3. قِس الدقة والموثوقية
قيّم المخرجات مقابل مراجع موثوقة.
تتبع الأخطاء الواقعية، والالتزام بالتعليمات، والاتساق، وكمية التصحيح البشري المطلوبة.
4. احسب التكلفة لكل مهمة مقبولة
بدلًا من التركيز على أسعار الرموز فقط، احسب:
التكلفة لكل مهمة مقبولة = (تكلفة استخدام النموذج + تكلفة الإعادة + تكلفة المراجعة) ÷ المهام المقبولة
وهذا يلتقط التكلفة الفعلية لإنتاج نتائج قابلة للاستخدام.
5. تحقّق من توافق سير العمل
قبل نشر نموذج، راجع متطلبات التعامل مع البيانات والتكاملات والمراقبة وضوابط الحوكمة.
قد يحقق نموذج أداءً جيدًا في الاختبار، لكنه لا يزال يحتاج إلى عمل تكامل كبير قبل أن يصبح مناسبًا للإنتاج.
لإطار اختيار أوسع، اقرأ أفضل روبوت دردشة بالذكاء الاصطناعي للأعمال: كيف تقارن الخيارات.
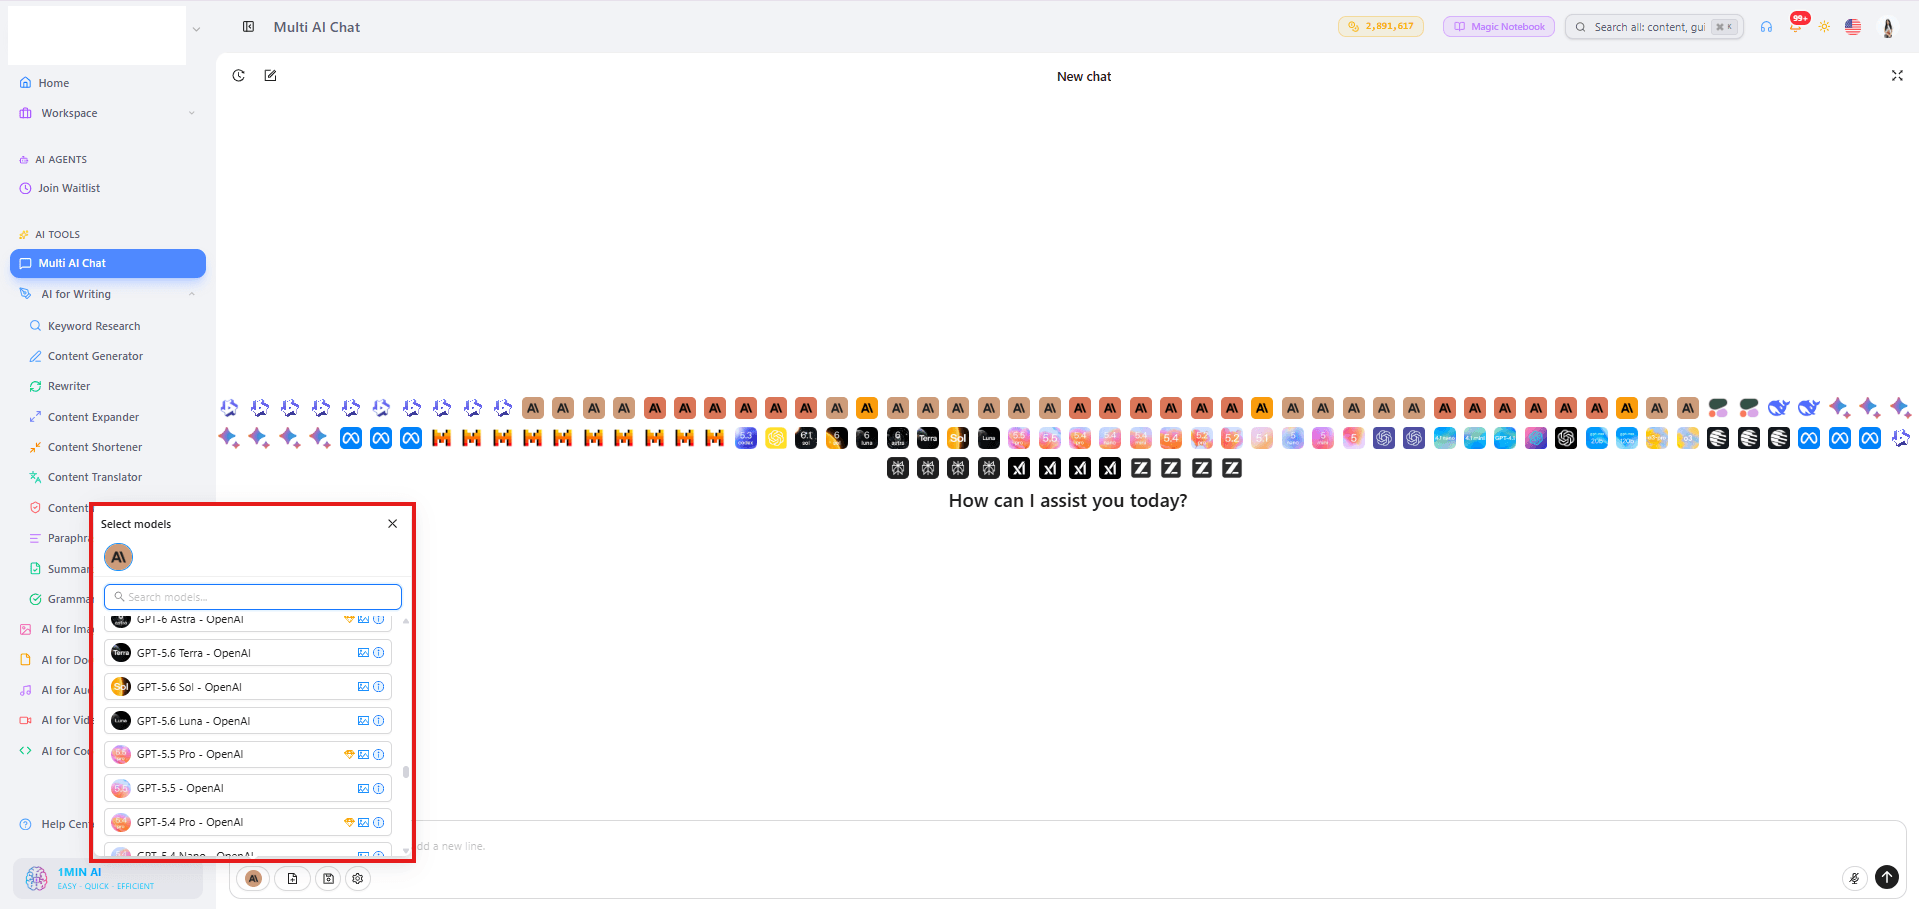
قارن نماذج الذكاء الاصطناعي في مساحة عمل واحدة مع 1min.AI
قد تجعل مقارنة النماذج عبر واجهات منفصلة عملية التقييم أصعب في الإدارة.
يوفر 1min.AI مساحة عمل موحدة للوصول إلى عدة نماذج ذكاء اصطناعي مدعومة وإنجاز المهام المدعومة بالذكاء الاصطناعي.
باستخدام Multi AI Chat، يمكن للفرق إرسال المطالبة نفسها إلى النماذج المدعومة ومقارنة الردود جنبًا إلى جنب.
يدعم Mix AI Models العمل مع نماذج مختلفة داخل المحادثة، بينما يساعد Document Chat المستخدمين على التفاعل مع مستندات الأعمال.
بالنسبة لقادة الذكاء الاصطناعي وفرق الابتكار، توفر هذه الميزات نقطة انطلاق عملية لمقارنة مخرجات النماذج قبل الالتزام بتطبيق أوسع.
يجب التحقق من نسخ GPT-6 وClaude 5.5 المحددة في قائمة النماذج الحالية داخل 1min.AI قبل الاختبار.
يمكن لمساحة العمل متعددة النماذج أن تبسط التقييم، لكن النشر الإنتاجي لا يزال يتطلب تكاملات مناسبة ومراجعات أمنية وضوابط تشغيلية.
الحكم النهائي: GPT-6 أم Claude 5.5؟
يتصدر Claude Opus 5.5 على GPT-6 Astra في عدة اختبارات معيارية مستقلة للذكاء والبرمجة. كما تظهر Claude Sonnet 5.5 وHaiku 5.5 نتائج قوية في مقارنات Anthropic المنشورة للعمل المهني والنماذج الصغيرة.
ومع ذلك، تظل نماذج GPT-6 منافسة، ويُظهر GPT-6 Astra كيف يمكن لأسعار الرموز الأعلى أن تترافق مع تكاليف أقل لمهام الاختبار.
بالنسبة للشركات، لا يوجد فائز واحد يناسب الجميع.
اختر النموذج الذي يحقق الدقة والموثوقية وتوافق سير العمل المطلوبين بأقل تكلفة إجمالية مستدامة.
بدلًا من تغيير المزودين بناءً على أحدث إصدار، اختبر عدة نماذج على أحمال عمل حقيقية وقِس النتائج.
استكشف 1min.AI لمقارنة نماذج الذكاء الاصطناعي المدعومة في مساحة عمل واحدة والعثور على الأنسب لأعمالك.
الأسئلة الشائعة
هل GPT-6 أفضل من Claude 5.5؟
ليس في كل اختبار معياري. يتصدر Claude Opus 5.5 في عدة تقييمات مستقلة للذكاء والبرمجة، بينما يؤدي GPT-6 Astra بشكل أفضل في بعض الاختبارات ويمكن أن تكون تكاليفه لكل مهمة معيارية أقل.
أيهما أفضل للبرمجة: GPT-6 أم Claude 5.5؟
يقدمان كلاهما نماذج تنافسية للبرمجة. يؤدي Claude Opus 5.5 أداءً قويًا في Terminal-Bench 4.0، بينما يتقدم GPT-6 Sol على Claude Sonnet 5.5 في مقارنة FrontierCode المذكورة. تعتمد النتائج على فئة النموذج وإعداد الجهد ومهمة البرمجة.
أيهما أقل تكلفة: GPT-6 أم Claude 5.5؟
يعتمد ذلك على النموذج وعبء العمل. أسعار الرموز المذكورة لـ Claude Opus 5.5 أقل من GPT-6 Astra، لكن الأخير قد يستخدم رموزًا أقل لكل مهمة. قارن التكاليف الإجمالية للمهمة المقبولة بدلًا من أسعار الرموز وحدها.
هل Claude 5.5 أفضل للمستندات التجارية؟
يؤدي Claude Sonnet 5.5 أداءً قويًا في اختبارات العمل المعرفي المنشورة. ومع ذلك، ينبغي على الشركات مقارنته مع نماذج GPT-6 باستخدام مستنداتها ومعايير التقييم الخاصة بها.
هل يمكنني مقارنة GPT-6 وClaude 5.5 باستخدام 1min.AI؟
يدعم 1min.AI مقارنة الردود من عدة نماذج ذكاء اصطناعي متاحة عبر Multi AI Chat. تحقّق من قائمة النماذج الحالية في المنصة للتأكد من توفر نسخ GPT-6 وClaude 5.5 المحددة التي تريد تقييمها.
- #Informational
بدائل
اكتشف أفضل البدائل لـ 1minAI وقارن الميزات والأسعار وحالات الاستخدام.
1min.AI مقابل OpenRouter
1min.AI مقابل OpenRouter: قارن منتج إنشاء الذكاء الاصطناعي الجاهز للاستخدام بأداة واجهة برمجة التطبيقات التقنية. اكتشف ما إذا كنت بحاجة إلى استوديو إبداعي بدون أي برمجة أو مركز بنية تحتية للترميز.
 Ngoc Hong
1min. AI مقابل Dola AI
هل تبحث عن بديل لـ Dola AI؟ قارن بين 1min.AI وDola AI من حيث إنشاء الفيديو، الخطط المجانية، التسعير والخصوصية لاختيار تطبيق الذكاء الاصطناعي المناسب.
Ngoc Hong
1minAI مقابل Hix AI
قارن 5 بدائل لـ HIX AI للدردشة بالذكاء الاصطناعي، والبحث، والكتابة، والصور، والفيديو، والتسعير، وسير العمل المرن للذكاء الاصطناعي.
Ngoc Hongأدوات الذكاء الاصطناعي
اكتشف أفضل أدوات الذكاء الاصطناعي لتعزيز الإنتاجية والإبداع والعمل اليومي.
أنشئ محتوى كرتونيًا متناسقًا في بضع خطوات فقط
أنشئ فيديوهات كرتونية لـ TikTok وReels في 3 خطوات بسيطة مع 1min.AI، من البحث عن الأفكار إلى الشخصيات والفيديوهات المتحركة.
 Lien Anh Vu
منتج واحد، 10 إبداعات UGC: كيف يجعل الذكاء الاصطناعي اختبار المحتوى أسهل
أنشئ محتوى UGC أكثر أصالة باستخدام مولّد فيديو UGC بالذكاء الاصطناعي، واختبر زوايا إبداعية أكثر، ووسّع محتوى التسويق بالعمولة دون تصوير كل نسخة.
Lien Anh Vu
أفضل 4 أدوات ذكاء اصطناعي بأسعار معقولة لمؤسسي الشركات الناشئة
اكتشف أفضل 4 أدوات ذكاء اصطناعي بأسعار معقولة لمؤسسي الشركات الناشئة للتحقق من صحة الأفكار وبناء المنتجات وإنشاء المحتوى وإطلاقها بشكل أسرع دون الإفراط في الإنفاق.
 Tram Ta
ميزات الذكاء الاصطناعي
ميزات شاملة للذكاء الاصطناعي تبسط سير العمل، وتحسن الكفاءة، وتمكن الفرق من تحقيق المزيد.
أنشئ محتوى كرتونيًا متناسقًا في بضع خطوات فقط
أنشئ فيديوهات كرتونية لـ TikTok وReels في 3 خطوات بسيطة مع 1min.AI، من البحث عن الأفكار إلى الشخصيات والفيديوهات المتحركة.
Lien Anh Vuمنتج واحد، 10 إبداعات UGC: كيف يجعل الذكاء الاصطناعي اختبار المحتوى أسهل
أنشئ محتوى UGC أكثر أصالة باستخدام مولّد فيديو UGC بالذكاء الاصطناعي، واختبر زوايا إبداعية أكثر، ووسّع محتوى التسويق بالعمولة دون تصوير كل نسخة.
Lien Anh Vu
1minAI: مدقق قواعد نحوية مجاني بالذكاء الاصطناعي
تحقق من القواعد مجانًا مع مدقق القواعد بالذكاء الاصطناعي من 1minAI. اعثر على أخطاء القواعد والإملاء والكتابة، وحسّن الوضوح، وصقل محتواك في ثوانٍ.
Tram Taحالات استخدام الذكاء الاصطناعي
مجموعة منسقة من حالات استخدام الذكاء الاصطناعي للأعمال والإنتاجية والتطبيقات الخاصة بالصناعة.
أنشئ محتوى كرتونيًا متناسقًا في بضع خطوات فقط
أنشئ فيديوهات كرتونية لـ TikTok وReels في 3 خطوات بسيطة مع 1min.AI، من البحث عن الأفكار إلى الشخصيات والفيديوهات المتحركة.
Lien Anh Vuمنتج واحد، 10 إبداعات UGC: كيف يجعل الذكاء الاصطناعي اختبار المحتوى أسهل
أنشئ محتوى UGC أكثر أصالة باستخدام مولّد فيديو UGC بالذكاء الاصطناعي، واختبر زوايا إبداعية أكثر، ووسّع محتوى التسويق بالعمولة دون تصوير كل نسخة.
Lien Anh Vu
أفضل وقت للنشر على إنستغرام: دليل عملي لتحقيق تفاعل أفضل
اكتشف أفضل وقت للنشر على إنستغرام، بما في ذلك أفضل الأيام والأوقات لجماهير مختلفة، بالإضافة إلى نصائح للعثور على جدول النشر المثالي لحسابك.
Tram Taدروس الذكاء الاصطناعي
تعلم كيفية استخدام الذكاء الاصطناعي من خلال دروس عملية وخطوة بخطوة.
أنشئ محتوى كرتونيًا متناسقًا في بضع خطوات فقط
أنشئ فيديوهات كرتونية لـ TikTok وReels في 3 خطوات بسيطة مع 1min.AI، من البحث عن الأفكار إلى الشخصيات والفيديوهات المتحركة.
Lien Anh Vu
عروض أدوات الذكاء الاصطناعي في الجمعة السوداء 2026
اكتشف ما الذي تقدمه عروض أدوات الذكاء الاصطناعي في الجمعة السوداء 2026. تعرّف على كيفية الحصول على صفقة 1min.AI مدى الحياة عبر AppSumo وDealify وStack Social، وتحقق من Trustpilot وSlashdot وSoftware Advice.
 Hang Nguyen
اتساق المنتج من صورة إلى فيديو بالذكاء الاصطناعي مع Seedance لإيقاف التشوّه وتوسيع مراجعات المنتجات
أوقف تشوّه الشعارات مع اتساق المنتج من صورة إلى فيديو بالذكاء الاصطناعي وأنشئ اليوم على 1min.AI فيديوهات مراجعة بجودة استوديو.
Lien Anh Vuأدلة الذكاء الاصطناعي
تعلم الذكاء الاصطناعي بشكل أسرع باستخدام أدلة عملية وأمثلة واقعية وأفضل الممارسات القابلة للتطبيق.
أنشئ محتوى كرتونيًا متناسقًا في بضع خطوات فقط
أنشئ فيديوهات كرتونية لـ TikTok وReels في 3 خطوات بسيطة مع 1min.AI، من البحث عن الأفكار إلى الشخصيات والفيديوهات المتحركة.
Lien Anh Vu
اشترِ أدوات الذكاء الاصطناعي بأمان عبر الإنترنت: دليل الجمعة السوداء 2026
اكتشف كيف تجد أفضل عروض الجمعة السوداء على أدوات الذكاء الاصطناعي وتحصل عليها بأمان عبر الإنترنت. تعلّم استراتيجيات خبراء لتجنب الاحتيال، والتغلب على إرهاق الاشتراكات، والتحقق من البرامج.
Hang Nguyenاتساق المنتج من صورة إلى فيديو بالذكاء الاصطناعي مع Seedance لإيقاف التشوّه وتوسيع مراجعات المنتجات
أوقف تشوّه الشعارات مع اتساق المنتج من صورة إلى فيديو بالذكاء الاصطناعي وأنشئ اليوم على 1min.AI فيديوهات مراجعة بجودة استوديو.
Lien Anh Vuحلول الذكاء الاصطناعي
تصفح أفضل حلول الذكاء الاصطناعي للأتمتة، والبرمجة، والبحث، والإنتاجية، ودعم العملاء، والتسويق، وسير عمل الأعمال.
أنشئ محتوى كرتونيًا متناسقًا في بضع خطوات فقط
أنشئ فيديوهات كرتونية لـ TikTok وReels في 3 خطوات بسيطة مع 1min.AI، من البحث عن الأفكار إلى الشخصيات والفيديوهات المتحركة.
Lien Anh Vuمنتج واحد، 10 إبداعات UGC: كيف يجعل الذكاء الاصطناعي اختبار المحتوى أسهل
أنشئ محتوى UGC أكثر أصالة باستخدام مولّد فيديو UGC بالذكاء الاصطناعي، واختبر زوايا إبداعية أكثر، ووسّع محتوى التسويق بالعمولة دون تصوير كل نسخة.
Lien Anh Vu
مولّد وشوم بالذكاء الاصطناعي مجانًا: تصاميم مخصصة
حوّل أي فكرة إلى تصميم وشم مخصص باستخدام مولّد الوشوم بالذكاء الاصطناعي المجاني من 1min.AI. صف فكرتك، واختر النمط، وحمّلها في ثوانٍ.
 Trang Tran
نماذج الذكاء الاصطناعي
استكشف أبرز نماذج الذكاء الاصطناعي في مكان واحد.
أنشئ محتوى كرتونيًا متناسقًا في بضع خطوات فقط
أنشئ فيديوهات كرتونية لـ TikTok وReels في 3 خطوات بسيطة مع 1min.AI، من البحث عن الأفكار إلى الشخصيات والفيديوهات المتحركة.
Lien Anh Vuمنتج واحد، 10 إبداعات UGC: كيف يجعل الذكاء الاصطناعي اختبار المحتوى أسهل
أنشئ محتوى UGC أكثر أصالة باستخدام مولّد فيديو UGC بالذكاء الاصطناعي، واختبر زوايا إبداعية أكثر، ووسّع محتوى التسويق بالعمولة دون تصوير كل نسخة.
Lien Anh Vuاتساق المنتج من صورة إلى فيديو بالذكاء الاصطناعي مع Seedance لإيقاف التشوّه وتوسيع مراجعات المنتجات
أوقف تشوّه الشعارات مع اتساق المنتج من صورة إلى فيديو بالذكاء الاصطناعي وأنشئ اليوم على 1min.AI فيديوهات مراجعة بجودة استوديو.
Lien Anh Vuمقارنات الذكاء الاصطناعي
قارن أدوات ونماذج ومنصات الذكاء الاصطناعي للعثور على الأنسب لاحتياجاتك.
Kling AI مقابل Veo 3: أي نموذج يفوز؟
Kling AI مقابل Veo 3: قارن الحركة والصوت الأصلي والتسعير والخطط المجانية لمعرفة أي مولّد فيديو بالذكاء الاصطناعي يناسب مشروعك - جرّب كليهما على 1min.AI.
Trang Tranاتساق المنتج من صورة إلى فيديو بالذكاء الاصطناعي مع Seedance لإيقاف التشوّه وتوسيع مراجعات المنتجات
أوقف تشوّه الشعارات مع اتساق المنتج من صورة إلى فيديو بالذكاء الاصطناعي وأنشئ اليوم على 1min.AI فيديوهات مراجعة بجودة استوديو.
Lien Anh Vu
مقارنة DeepSeek V4 Pro مقابل Flash
قارن مقاييس DeepSeek V4 Pro مقابل DeepSeek V4 Flash. قم بتحسين تطبيقاتك الوكيلة وتحسين التحقق من حقائق الذكاء الاصطناعي على 1min.ai اليوم.
تكاملات الذكاء الاصطناعي
ادمج الذكاء الاصطناعي بسلاسة مع الأدوات التي تستخدمها بالفعل لأتمتة العمل وتعزيز الإنتاجية.
كيفية استخدام مولّد فيديو أزياء بالذكاء الاصطناعي لأسبوع الموضة 2026
حوّل أفكار أسبوع الموضة 2026 إلى مقاطع فيديو أزياء مذهلة باستخدام الذكاء الاصطناعي. تعلّم كيف تولّد الأفكار، وتبتكر المرئيات، وتحول الصور إلى فيديوهات عبر سير عمل بسيط واحد.
Lien Anh Vu
منظور الشخص: لديك أكثر من 10 منشورات لتُنشئها كل يوم
تعرّف على كيفية بناء سير عمل للمحتوى بالذكاء الاصطناعي يساعد صنّاع المحتوى على إنتاج أكثر من 10 منشورات يوميًا بشكل أسرع عبر العصف الذهني بالذكاء الاصطناعي، وتوليد الصور، وإنشاء المحتوى.
Lien Anh Vu
توقف عن التبديل بين تطبيقات الذكاء الاصطناعي: كيف يحوّل تكامل الذكاء الاصطناعي العلامة التجارية لصاحب العمل
اكتشف كيف يساعد تكامل الذكاء الاصطناعي فرق الموارد البشرية على تبسيط العلامة التجارية لصاحب العمل من خلال الجمع بين الكتابة بالذكاء الاصطناعي، المستندات، الصور، الفيديو، ونماذج الذكاء الاصطناعي المتعددة في مساحة عمل واحدة.
Tram Taالذكاء الاصطناعي للصناعات
اكتشف أفضل أدوات الذكاء الاصطناعي وسير العمل للرعاية الصحية، المالية، التعليم، القانون، التصنيع، التجزئة، العقارات، والمزيد.
مولّد مجاني لوصف المنتجات بالذكاء الاصطناعي
اكتب أوصاف منتجات تبيع خلال دقائق. استخدم هذا المولّد المجاني لوصف المنتجات بالذكاء الاصطناعي لتحويل التفاصيل أو صورة إلى نص متوافق مع علامتك. جرّب 1min.AI.
Trang Tran
أفضل أدوات إنتاجية الأعمال للشركات الناشئة لتعظيم الأرباح | 1minAI
اكتشف أفضل أدوات إنتاجية الأعمال للشركات الناشئة لتوفير الوقت، وتبسيط سير العمل، وتقليل المهام المتكررة، ودعم النمو المربح بالذكاء الاصطناعي.
Tram Ta
أفضل أداة ذكاء اصطناعي لتسويق المحتوى |1minAI
هل تبحث عن أفضل أداة ذكاء اصطناعي لتسويق المحتوى؟ اكتشف كيف تساعد 1minAI المسوقين على البحث والكتابة وإعادة التوظيف وإنشاء المرئيات وتوسيع المحتوى من مساحة عمل واحدة للذكاء الاصطناعي.
Tram Taوكلاء الذكاء الاصطناعي
اكتشف وقم بتشغيل وكلاء الذكاء الاصطناعي لأتمتة المهام عبر عملك وحياتك اليومية.
1minAI: مدقق قواعد نحوية مجاني بالذكاء الاصطناعي
تحقق من القواعد مجانًا مع مدقق القواعد بالذكاء الاصطناعي من 1minAI. اعثر على أخطاء القواعد والإملاء والكتابة، وحسّن الوضوح، وصقل محتواك في ثوانٍ.
Tram Ta
وكلاء الذكاء الاصطناعي لفيسبوك
استخدم وكيل ذكاء اصطناعي لفيسبوك لإنشاء المحتوى، وتوليد الصور، وجدولة المنشورات، والنشر من مستنداتك ومحادثاتك.
Ngoc Hong
وكيل الذكاء الاصطناعي أم مساعد الذكاء الاصطناعي: أيهما يوفّر للمصممين وقتًا أكثر فعلًا؟
تعرّف على الفرق بين وكيل الذكاء الاصطناعي ومساعد الذكاء الاصطناعي، واكتشف أي حل يساعد المصممين على أتمتة الأعمال المتكررة وتقليل المراجعات وتوفير المزيد من الوقت.
Lien Anh Vuسير عمل الذكاء الاصطناعي
استكشف سير عمل الذكاء الاصطناعي الجاهزة للاستخدام للإنتاجية والتسويق والمبيعات والدعم والمزيد.
أنشئ محتوى كرتونيًا متناسقًا في بضع خطوات فقط
أنشئ فيديوهات كرتونية لـ TikTok وReels في 3 خطوات بسيطة مع 1min.AI، من البحث عن الأفكار إلى الشخصيات والفيديوهات المتحركة.
Lien Anh Vuمنتج واحد، 10 إبداعات UGC: كيف يجعل الذكاء الاصطناعي اختبار المحتوى أسهل
أنشئ محتوى UGC أكثر أصالة باستخدام مولّد فيديو UGC بالذكاء الاصطناعي، واختبر زوايا إبداعية أكثر، ووسّع محتوى التسويق بالعمولة دون تصوير كل نسخة.
Lien Anh Vuكيفية استخدام مولّد فيديو أزياء بالذكاء الاصطناعي لأسبوع الموضة 2026
حوّل أفكار أسبوع الموضة 2026 إلى مقاطع فيديو أزياء مذهلة باستخدام الذكاء الاصطناعي. تعلّم كيف تولّد الأفكار، وتبتكر المرئيات، وتحول الصور إلى فيديوهات عبر سير عمل بسيط واحد.
Lien Anh Vuالنشرة الإخبارية
ابتكارات الذكاء الاصطناعي الأسبوعية مع 1minAI
🔮 ابتكارات الذكاء الاصطناعي الأسبوعية #142: Grok 4.7 وOpus 5.5 وSonnet 5.5 على 1min.ai
احصل على Grok 4.7 وClaude Opus 5.5 وSonnet 5.5 على 1min.ai. خفّض تكاليف الاشتراك بنسبة تصل إلى 70% وعالج ملايين الرموز في مساحة عمل موحّدة واحدة.
Hang Nguyen
🔮 تحديثات الذكاء الاصطناعي الأسبوعية #143: تحديث تحديث GPT-6 وGPT-6.1 وIdeogram 4.0 وIdeogram 4.0
تَصِل إلى GPT-6 Sol وLuna وGPT-6.1 Sol وIdeogram 4.0 على 1min.ai. ارفع دقة الطباعة إلى 98.4% وخفّض زمن الاستدلال بنسبة 45% في منصة واحدة.
Hang Nguyen
🔮 ابتكارات الذكاء الاصطناعي الأسبوعية #141: Seedance 2.5 و Stable Audio 3: الجيل التالي من الذكاء الاصطناعي
استكشف Seedance 2.0 و2.5 وStable Audio 3 من StabilityAI على 1min.ai. أنشئ صوتًا بجودة الاستوديو وحركة متزامنة باستخدام الذكاء الاصطناعي التوليدي من الجيل التالي.
Hang Nguyen