
适合商业用途的最佳 LLM:如何按任务选择

Ngoc Hong
2026年10月16日
在找最佳 LLM?排行榜之所以各说各话,是因为模型擅长的任务不同。用这个框架来测试并选出最合适的模型。
适合商业用途的最佳 LLM:如何按任务选择
最佳 LLM 取决于你的任务,而不是某个排行榜上的单一名次。这里的 LLM 指的是大语言模型,也就是现代聊天机器人和助手背后的 AI。根据 最近一份第三方排行榜汇总,2026 年 10 月发布的排名并没有一致的冠军,因为每个榜单衡量的东西都不同。对正从试点走向正式上线的 AI 负责人来说,真正该问的是:哪个模型最适合你的工作流。本文会教你如何解读 LLM 排名、做一个简单测试,并并排比较模型。
为什么最佳 LLM 排名会不一致
LLM 排名看起来很客观,但每个榜单回答的是不同问题。先弄清楚分数衡量的是什么,才能避免因为错误理由选错模型。
2026 年 10 月的汇总显示,不同基准下的领先者并不一样。文本偏好榜单与代理式或终端测试指向的模型也不同。这很正常:一个模型可能在通用推理上领先,却在成本、速度,或某项窄能力如编程上落后。
| 排名类型 | 衡量内容 | 适用场景 | 盲点 |
|---|---|---|---|
| 独立基准指数,例如 Artificial Analysis Intelligence Index | 由一个实验室用英文文本提示运行的标准化测试综合得分 | 比较原始能力,以及价格和速度 | 没有人类偏好信号;测试未必与你的任务匹配 |
| 人类偏好竞技场,例如 Arena | 用户匿名一对一投票,再转换为类似 Elo 的分数 | 判断聊天质量和风格 | 分数可能受回复长度、排版和语气影响 |
| 任务基准测试(编程、代理式、长上下文) | 针对某项技能的固定题集 | 窄而具体的决策 | 固定题集会随时间饱和并泄题 |
想了解这些系统如何运作,可查看这篇 LLM 排名方法解析 和这篇 Arena 评分构成概览。
因此,某张图表上的最先进(SOTA)LLM 只是起点,不是最终结论。任何 AI 排名也会很快过时,因为新模型发布得很频繁。
如何为你的工作流选择最佳 LLM
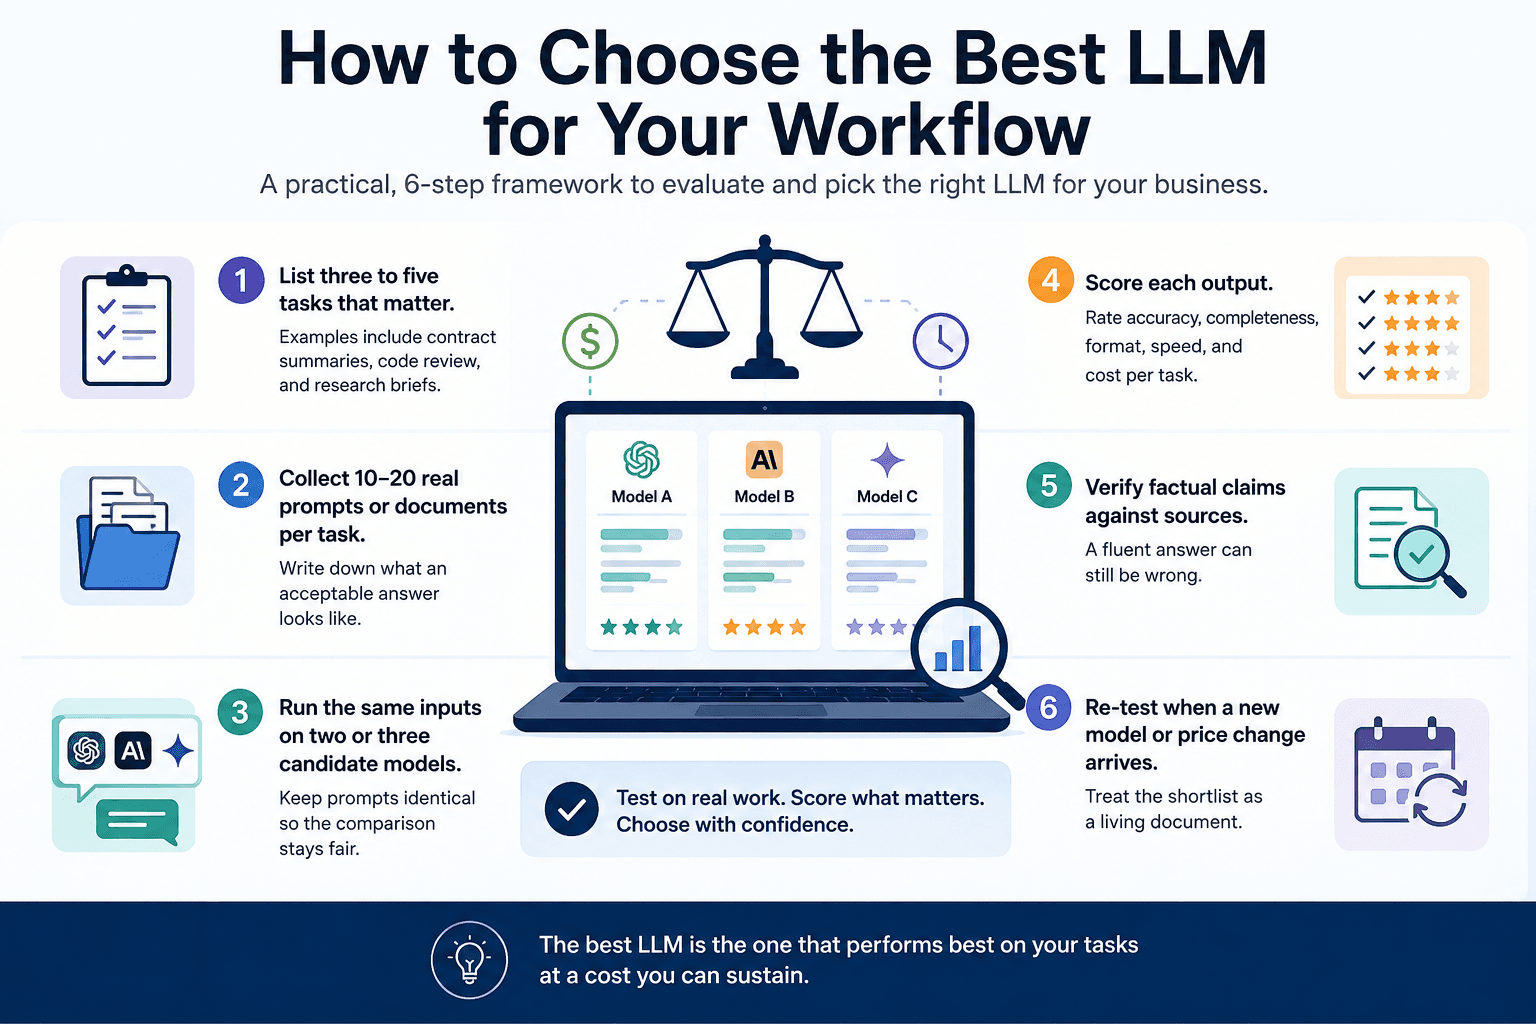
挑选最佳 LLM 的方式和供应商评估类似:先定义工作内容,在真实材料上测试,再给结果打分。以下步骤只需几个小时,不必花上几周。
- 列出三个到五个重要任务。 例如合同摘要、代码审查和研究简报。
- 为每个任务收集 10 到 20 个真实提示或文档。 写下什么样的答案算可接受。
- 把相同输入分别跑在两到三个候选模型上。 保持提示词完全一致,确保比较公平。
- 给每个输出打分。 按准确性、完整性、格式、速度和每项任务成本评分。
- 对照来源核实事实性表述。 流畅的答案也可能是错的。
- 当有新模型或价格变化时重新测试。 把候选清单当作动态文档。
不同任务奖励的能力不同,因此评分时也要相应加权。
| 任务 | 优先关注 | 如何测试 |
|---|---|---|
| 复杂推理 | 多步骤问题的准确性 | 使用有标准答案的提示 |
| 长文档 | 上下文长度和细节记忆 | 询问埋在文档中部的事实 |
| 研究与事实核查 | 来源使用和最新信息 | 用来源逐条核对每个说法 |
| 编程 | 正确输出、更少调试轮次 | 用你自己的测试运行代码 |
| 大批量工作 | 单任务成本和速度 | 估算每 1,000 个任务的成本 |
开放权重模型适合需要部署控制权的团队,不过 规模最大的模型可能需要相当可观的基础设施。
在 1min.AI 中并排比较最佳 AI LLM 选项
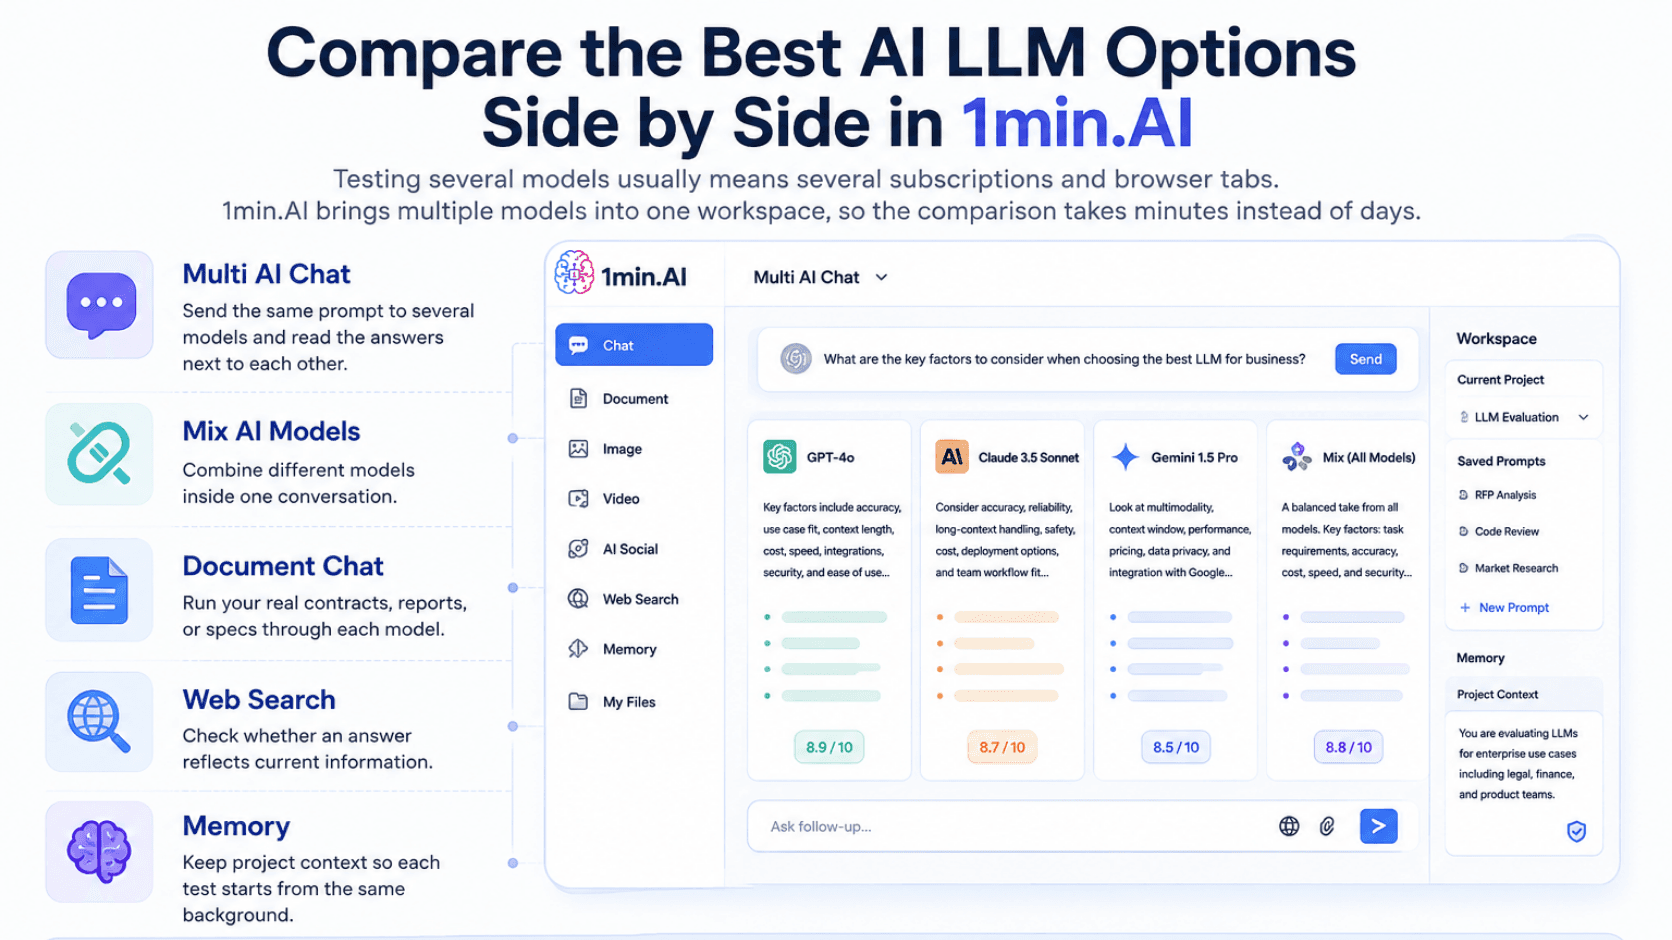
测试多个模型通常意味着要开多个订阅和浏览器标签页。1min.AI 将多个模型整合到一个工作区里,让比较只需几分钟,而不是几天。
- Multi AI Chat: 向多个模型发送同一个提示,并把答案并排查看。
- Mix AI Models: 在一次对话中组合不同模型。
- Document Chat: 用你的真实合同、报告或规格文档逐一测试每个模型。
- Web Search: 检查答案是否反映最新信息。
- Memory: 保留项目上下文,让每次测试都从相同背景开始。
这个工作区可访问 OpenAI、Anthropic 和 Google 等提供商的模型。开始测试前,请先在账号里查看当前可用的模型列表。1min.AI 不会取代你自己的评估,它只是减少切换成本,让你能更频繁地做评估。
最佳 LLM 常见问题
以下是读者接下来最常搜索的追问。
我该信哪个 LLM 排名?
不要只看一个。独立指数能显示能力、价格和速度,而人类偏好竞技场能显示聊天质量。务必查看日期,然后用你自己的测试确认。
最好的开源 LLM 是什么?
这取决于你的工作负载和硬件。如今有几款开放权重模型在公开基准上已能与专有模型竞争,但最大的那些需要多节点 GPU 集群。请按许可证、规模和任务匹配度缩小范围。
最好的本地 LLM 是什么?
对于本地使用,内存是主要限制。像 基于来源核查的精选列表 那样,从许可证、内存需求和运行时支持来比较候选。Ollama 等工具可以在你自己的机器上运行模型。
最好的免费 LLM 是什么?
免费使用经常变化,很多提供商也会限制用量。先查看各家的当前限制,再用你的真实提示词测试免费方案,确认可用后再依赖它。
Claude、Grok 或 DeepSeek 是不是最佳 LLM?
它们都可能在某些任务上很强,但没有一个能赢下所有任务。把相同提示词发给你的候选模型并比较结果,不要只看品牌口碑。
Reddit 推荐靠谱吗?
社区帖子能分享实用感受,但都只是个人经验。可以用来找测试灵感,而不是当作某个模型最好的证据。
用真实测试选出你的最佳 LLM
最佳 LLM 是能在你任务上表现出色、且成本你能长期承担的那一个。先用排行榜筛出候选,再拿两到三个模型在真实工作上测试。在 1min.AI 开始并排比较。
- #Information
替代方案
探索 1minAI 的最佳替代方案,并比较其功能、定价和用例。

1min.AI vs OpenRouter
1min.AI vs. OpenRouter:比较即用型 AI 创作产品与技术型 API 工具。看看你需要的是零代码创意工作室,还是编码基础设施枢纽。
 Ngoc Hong

1min. AI vs Dola AI
正在寻找 Dola AI 替代方案?比较 1min.AI 和 Dola AI 在视频生成、免费方案、定价和隐私方面的差异,帮你选对 AI 应用。
Ngoc Hong
1minAI 与 Hix AI 对比
比较 5 个 HIX AI 替代方案,涵盖 AI 聊天、研究、写作、图片、视频、定价和灵活 AI 工作流。
Ngoc HongAI 工具
发现最佳 AI 工具,提升生产力、创造力及日常工作效率。

一个产品,10 个 UGC 创意:AI 如何让内容测试更轻松
使用 AI UGC 视频生成器打造更真实的 UGC,测试更多创意角度,并在无需为每个版本拍摄的情况下扩展联盟营销内容。
 Lien Anh Vu

只需几步,打造风格统一的卡通内容
使用 1min.AI,只需 3 个简单步骤,就能为 TikTok 和 Reels 制作卡通视频,从构思点子到角色和动画视频,一站完成。
Lien Anh Vu
初创创办人首选的 4 款平价 AI 工具
了解初创创办人最值得入手的 4 款平价 AI 工具,助你验证想法、打造产品、创建内容并更快推出市场,同时控制成本。
 Tram Ta
AI 功能
全面的 AI 功能,优化工作流程、提高效率,赋能团队实现更多。
一个产品,10 个 UGC 创意:AI 如何让内容测试更轻松
使用 AI UGC 视频生成器打造更真实的 UGC,测试更多创意角度,并在无需为每个版本拍摄的情况下扩展联盟营销内容。
Lien Anh Vu只需几步,打造风格统一的卡通内容
使用 1min.AI,只需 3 个简单步骤,就能为 TikTok 和 Reels 制作卡通视频,从构思点子到角色和动画视频,一站完成。
Lien Anh Vu
1minAI:免费 AI 语法检查器
使用 1minAI 的 AI 语法检查器免费检查语法。快速找出语法、拼写和写作错误,提升表达清晰度,让内容更精炼。
Tram TaAI 应用场景
精心整理的 AI 用例,适用于商业、提高生产力及各行业专属应用。
一个产品,10 个 UGC 创意:AI 如何让内容测试更轻松
使用 AI UGC 视频生成器打造更真实的 UGC,测试更多创意角度,并在无需为每个版本拍摄的情况下扩展联盟营销内容。
Lien Anh Vu只需几步,打造风格统一的卡通内容
使用 1min.AI,只需 3 个简单步骤,就能为 TikTok 和 Reels 制作卡通视频,从构思点子到角色和动画视频,一站完成。
Lien Anh Vu
Instagram 最佳发帖时间:提升互动的实用指南
了解 Instagram 的最佳发帖时间,包括不同受众的最佳日期和时段,以及为你的账号找到理想发帖排程的技巧。
Tram TaAI 教程
通过实用的分步教程学习如何使用人工智能。
只需几步,打造风格统一的卡通内容
使用 1min.AI,只需 3 个简单步骤,就能为 TikTok 和 Reels 制作卡通视频,从构思点子到角色和动画视频,一站完成。
Lien Anh Vu
2026 黑色星期五 AI 工具优惠
了解 2026 黑色星期五 AI 工具优惠有哪些。看看如何通过 AppSumo、Dealify、Stack Social 获取 1min.AI 终身优惠,并在 Trustpilot、Slashdot 和 Software Advice 上验证。
 Hang Nguyen

使用 Seedance 实现 AI 图像转视频的产品一致性,防止变形并扩大量化评测内容
用 AI 图像转视频产品一致性,停止徽标变形,今天就在 1min.AI 生成专业级评测视频。
Lien Anh VuAI 指南
通过实用指南、真实案例和可操作的最佳实践,更快地学习 AI。
只需几步,打造风格统一的卡通内容
使用 1min.AI,只需 3 个简单步骤,就能为 TikTok 和 Reels 制作卡通视频,从构思点子到角色和动画视频,一站完成。
Lien Anh Vu
安全在线购买 AI 工具:2026 黑色星期五指南
了解如何在线找到并抢购最划算的黑色星期五 AI 优惠。学习避免诈骗、应对订阅疲劳并验证软件的专家策略。
Hang Nguyen使用 Seedance 实现 AI 图像转视频的产品一致性,防止变形并扩大量化评测内容
用 AI 图像转视频产品一致性,停止徽标变形,今天就在 1min.AI 生成专业级评测视频。
Lien Anh VuAI 解决方案
浏览适用于自动化、编码、研究、生产力、客户支持、营销和业务工作流程的最佳AI解决方案。
一个产品,10 个 UGC 创意:AI 如何让内容测试更轻松
使用 AI UGC 视频生成器打造更真实的 UGC,测试更多创意角度,并在无需为每个版本拍摄的情况下扩展联盟营销内容。
Lien Anh Vu只需几步,打造风格统一的卡通内容
使用 1min.AI,只需 3 个简单步骤,就能为 TikTok 和 Reels 制作卡通视频,从构思点子到角色和动画视频,一站完成。
Lien Anh Vu
免费 AI 纹身生成器:定制设计
用 1min.AI 的免费 AI 纹身生成器,把任何想法变成定制纹身设计。描述你的想法,选择风格,几秒内即可下载。
 Trang Tran
AI 模型
在一个地方探索全球领先的AI模型。
一个产品,10 个 UGC 创意:AI 如何让内容测试更轻松
使用 AI UGC 视频生成器打造更真实的 UGC,测试更多创意角度,并在无需为每个版本拍摄的情况下扩展联盟营销内容。
Lien Anh Vu只需几步,打造风格统一的卡通内容
使用 1min.AI,只需 3 个简单步骤,就能为 TikTok 和 Reels 制作卡通视频,从构思点子到角色和动画视频,一站完成。
Lien Anh Vu使用 Seedance 实现 AI 图像转视频的产品一致性,防止变形并扩大量化评测内容
用 AI 图像转视频产品一致性,停止徽标变形,今天就在 1min.AI 生成专业级评测视频。
Lien Anh VuAI 对比
对比AI工具、模型和平台,找到最适合您需求的选择。

Kling AI Vs Veo 3:哪个模型胜出?
Kling AI vs Veo 3:比较运动表现、原生音频、定价与免费层级,看看哪个 AI 视频生成器更适合你的项目——在 1min.AI 上同时试用两者。
Trang Tran使用 Seedance 实现 AI 图像转视频的产品一致性,防止变形并扩大量化评测内容
用 AI 图像转视频产品一致性,停止徽标变形,今天就在 1min.AI 生成专业级评测视频。
Lien Anh Vu
DeepSeek V4 Pro vs Flash 对比
比较 DeepSeek V4 Pro 与 DeepSeek V4 Flash 的指标。立即在 1min.ai 优化你的 agentic 应用并提升 AI 事实核查能力。
Ngoc HongAI 集成
将 AI 无缝集成到您常用的工具中,实现工作自动化并提升生产力。

如何使用 AI 时尚视频生成器打造 2026 时装周内容
借助 AI 将 2026 时装周灵感变成惊艳的时尚视频。了解如何进行头脑风暴、创建视觉效果,并通过一个简单工作流把图片转成视频。
Lien Anh Vu
观点:你每天要做 10+ 篇帖子
了解如何打造 AI 内容工作流,借助 AI 头脑风暴、图片生成和内容创作,帮助内容创作者更快地每天产出 10+ 条社媒帖子。
Lien Anh Vu
告别在不同 AI 应用间切换:AI 集成如何改变雇主品牌建设
了解 AI 集成如何通过将 AI 写作、文档、图片、视频和多个 AI 模型整合到一个工作区,帮助 HR 团队简化雇主品牌建设。
Tram Ta行业AI
为医疗、金融、教育、法律、制造、零售、房地产等行业寻找最佳AI工具和工作流程。

免费 AI 产品描述生成器
几分钟内写出能促成销售的产品描述。使用这款免费 AI 产品描述生成器,把产品细节或照片转成符合品牌调性的文案。试试 1min.AI。
Trang Tran
适合初创企业的最佳商业生产力工具,助你最大化利润 | 1minAI
发现适合初创企业的最佳商业生产力工具,帮助节省时间、简化工作流程、减少重复任务,并借助 AI 支持盈利增长。
Tram Ta
最佳内容营销 AI 工具 |1minAI
在找最佳内容营销 AI 工具?看看 1minAI 如何帮助营销人员在一个 AI 工作区里完成研究、写作、改写、视觉创作和内容扩展。
Tram TaAI 代理
探索并运行 AI 代理,自动完成您的工作和日常生活中的任务。
1minAI:免费 AI 语法检查器
使用 1minAI 的 AI 语法检查器免费检查语法。快速找出语法、拼写和写作错误,提升表达清晰度,让内容更精炼。
Tram Ta
用于 Facebook 的 AI 智能代理
使用 Facebook AI 智能代理来创建内容、生成图片、安排帖子,并根据你的文档和对话发布内容。
Ngoc Hong
AI Agent vs AI Assistant:哪一个真的能为设计师省更多时间?
了解 AI Agent 和 AI Assistant 的区别,看看哪种方案能帮助设计师自动化重复工作、减少修改,并节省更多时间。
Lien Anh VuAI 工作流程
探索即用型 AI 工作流程,提升生产力、营销、销售、支持等。
一个产品,10 个 UGC 创意:AI 如何让内容测试更轻松
使用 AI UGC 视频生成器打造更真实的 UGC,测试更多创意角度,并在无需为每个版本拍摄的情况下扩展联盟营销内容。
Lien Anh Vu只需几步,打造风格统一的卡通内容
使用 1min.AI,只需 3 个简单步骤,就能为 TikTok 和 Reels 制作卡通视频,从构思点子到角色和动画视频,一站完成。
Lien Anh Vu如何使用 AI 时尚视频生成器打造 2026 时装周内容
借助 AI 将 2026 时装周灵感变成惊艳的时尚视频。了解如何进行头脑风暴、创建视觉效果,并通过一个简单工作流把图片转成视频。
Lien Anh Vu简讯
与1minAI的每周AI创新

🔮 每周 AI 创新 #141:Seedance 2.5 与 Stable Audio 3:下一代 AI
在 1min.ai 探索 Seedance 2.0、2.5 以及 StabilityAI 的 Stable Audio 3。借助下一代生成式 AI,生成录音棚级音频和同步动作。
Hang Nguyen
🔮 每周 AI 创新 #121:Ideogram 3.0 和 Claude Opus 4.7 现已在 1min.ai 上线
Ideogram 3.0 和 Claude Opus 4.7 现已在 1min.ai 上线。在一个平台上生成完美无误的图片文字排版和高级文案。
 Uyen Hoang

🔮 每周 AI 创新 #134:在 AI Chat 体验免费 Qwen;3.7 和 3.6 系列更新
在寻找一款强大、免费的 AI 助手吗?来 1min.ai 探索最新的 Qwen 3.7 和 3.6 系列。今天就免费享受高速、准确的 AI 聊天!
Hang Nguyen