
商業用途最佳 LLM:如何按任務選擇

Ngoc Hong
2026年10月16日
正在尋找最佳 LLM?排名各有分歧,因為不同模型擅長的任務不同。用呢個框架去測試同揀出最適合你嘅一個。
商業用途最佳 LLM:如何按任務選擇
最佳 LLM 取決於你的任務,而唔係單一排行榜名次。喺呢度,LLM 即 large language model,即係現代聊天機械人同助手背後嘅 AI。根據 一份近期第三方排行榜綜述,2026 年 10 月發佈嘅排名並冇一致嘅冠軍,因為每個排名衡量嘅都唔同。對於由試點走向正式落地嘅 AI 領導者嚟講,真正問題係邊個模型喺你自己嘅工作流程表現最好。呢份指南會示範點樣閱讀 LLM 排名、進行簡單測試,並將模型並排比較。
點解最佳 LLM 排名會有分歧
LLM 排名睇落客觀,但每一個其實都回答緊唔同問題。了解分數代表乜,先唔會因為錯誤原因而揀錯模型。
2026 年 10 月嘅綜述顯示,唔同基準會得出唔同領先者。文本偏好榜同 agentic 或 terminal 測試,往往指向唔同模型。呢個好正常:一個模型可以喺通用推理領先,但喺成本、速度,或者某項窄技能例如編程方面落後。
| 排名類型 | 衡量內容 | 適用於 | 盲點 |
|---|---|---|---|
| 獨立基準索引,例如 Artificial Analysis Intelligence Index | 由單一實驗室用英文文本提示詞進行嘅標準化測試綜合得分 | 比較原始能力,以及價格同速度 | 冇人類偏好訊號;測試未必同你嘅任務一致 |
| 人類偏好對戰平台,例如 Arena | 由用戶盲選對戰投票,換算成類似 Elo 嘅分數 | 判斷聊天質素同風格 | 分數可能受回應長度、格式同語氣影響 |
| 任務基準(編程、agentic、長上下文) | 針對單一技能嘅固定題組 | 狹窄、具體嘅決策 | 固定題組會隨時間飽和同外洩 |
想了解更多呢啲系統點運作,可睇呢篇 LLM 排名方法說明 同呢篇 Arena 分數點樣計算嘅概覽。
所以,一張圖上嘅最先進(SOTA)LLM 只係起點,而唔係定論。任何 AI 排名都可能好快過時,因為新模型發佈得好頻密。
如何為你嘅工作流程揀出最佳 LLM
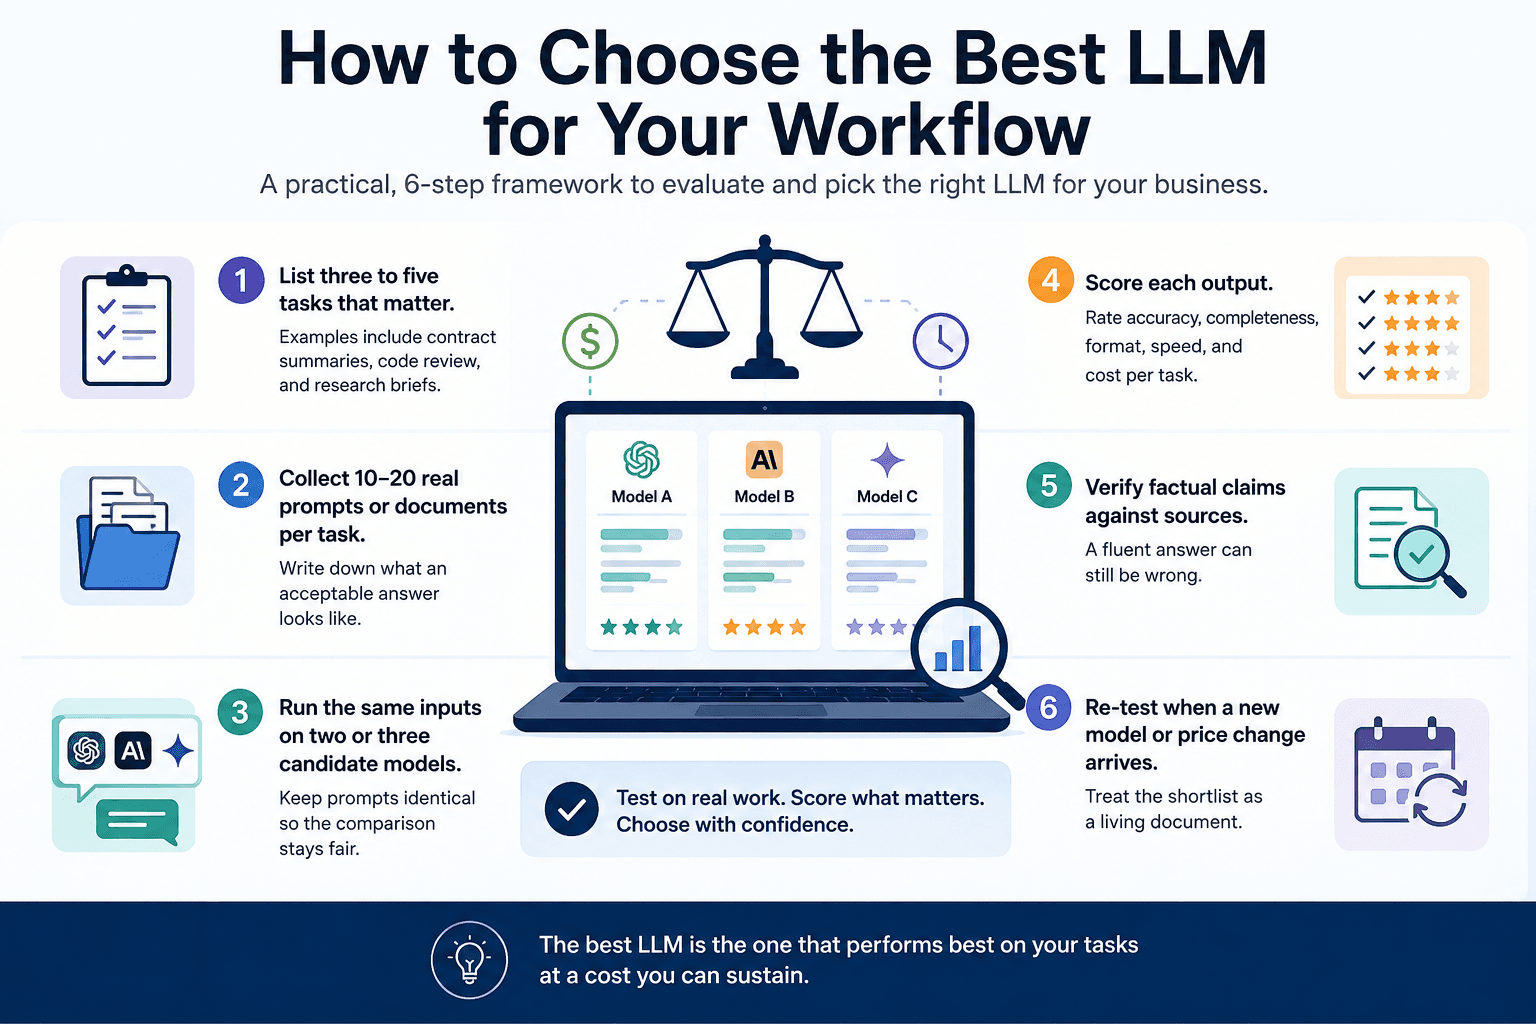
揀最佳 LLM 好似做任何供應商評估:定義工作、用真實材料測試,再為結果評分。以下步驟只需幾個鐘,唔使幾個禮拜。
- 列出三至五個重要任務。 例如合約摘要、程式碼審查同研究簡報。
- 每個任務收集 10–20 個真實提示詞或文件。 記低可接受答案應該係點。
- 用相同輸入喺兩至三個候選模型上測試。 保持提示詞一致,先至公平比較。
- 為每個輸出評分。 按準確度、完整性、格式、速度同每項任務成本評分。
- 用來源核實事實性聲稱。 流暢嘅答案都可能係錯。
- 當有新模型或價格變動時重新測試。 將候選名單當成會更新嘅文件。
唔同任務會獎勵唔同強項,所以要相應加權你嘅分數。
| 任務 | 應優先考慮 | 點樣測試 |
|---|---|---|
| 複雜推理 | 多步問題嘅準確度 | 有已知答案嘅提示詞 |
| 長文件 | 上下文長度同細節記憶 | 問埋藏喺文件中段嘅事實 |
| 研究同事實查核 | 來源使用同最新資訊 | 用來源逐條核對每項聲稱 |
| 編程 | 正確輸出、較少除錯循環 | 用你自己嘅測試去跑代碼 |
| 大量工作 | 每項任務成本同速度 | 估算每 1,000 項任務成本 |
開放權重模型適合需要部署控制嘅團隊,不過 最大型嘅模型可能需要大量基礎設施。
喺 1min.AI 並排比較最佳 AI LLM 選項
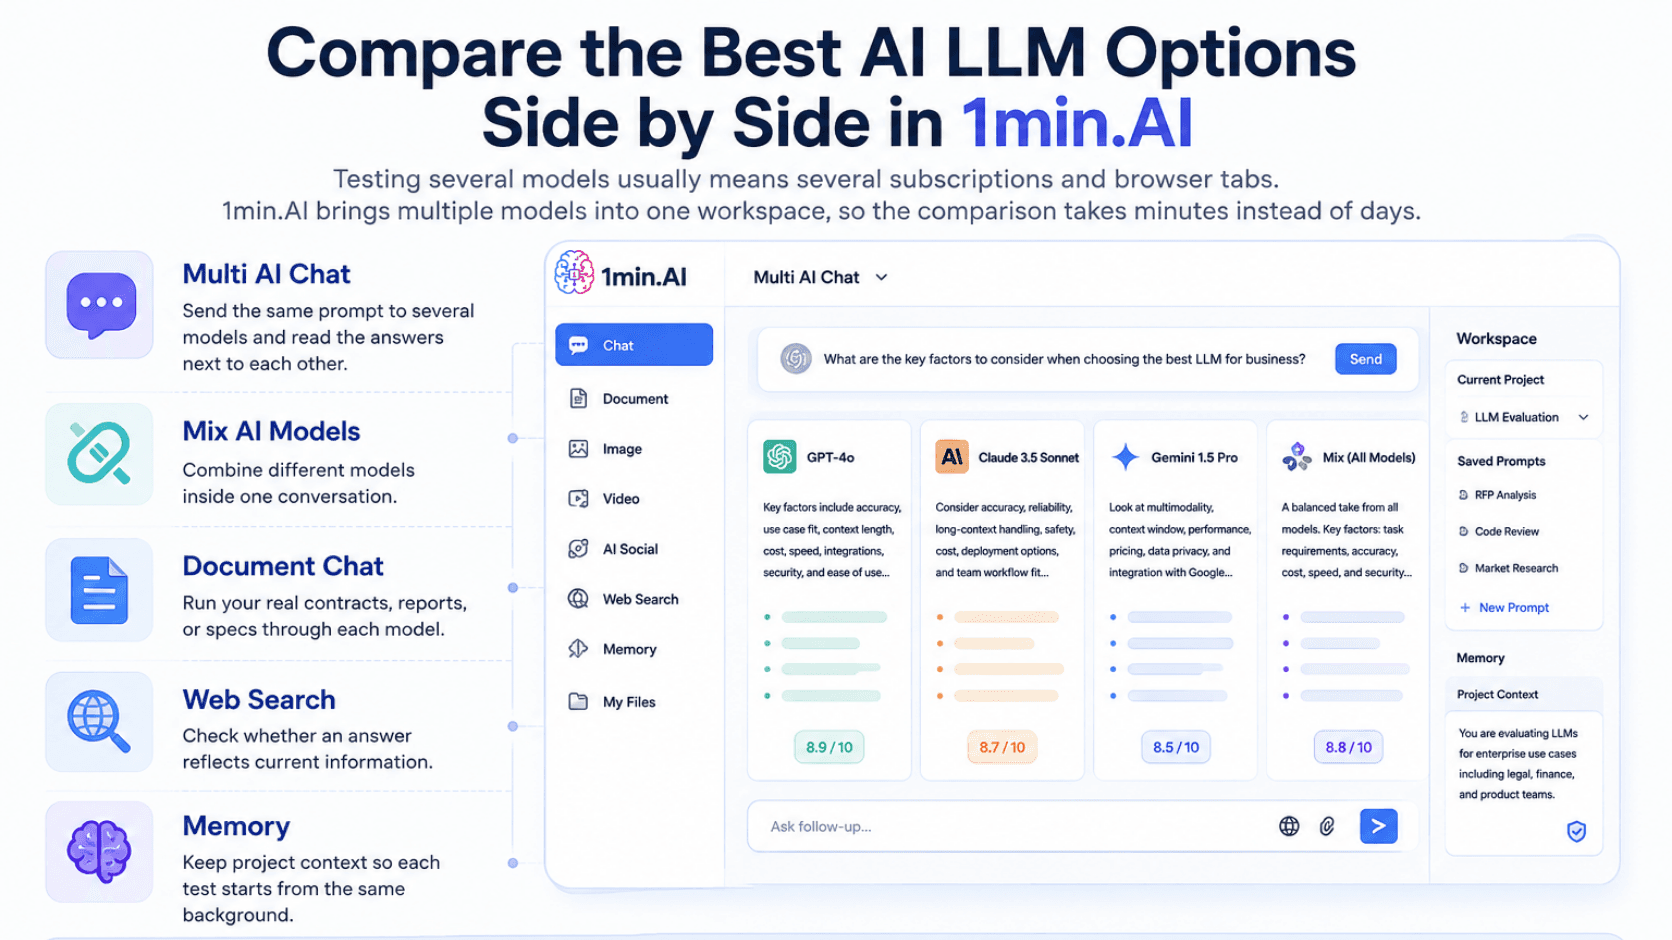
測試幾個模型通常代表要用幾個訂閱同幾個瀏覽器分頁。1min.AI 將多個模型整合到同一個工作區,所以比較只需幾分鐘,而唔係幾日。
- Multi AI Chat: 將同一個提示詞送畀幾個模型,再並排睇答案。
- Mix AI Models: 喺同一段對話入面結合唔同模型。
- Document Chat: 用你真實嘅合約、報告或規格去測試每個模型。
- Web Search: 檢查答案係咪反映最新資訊。
- Memory: 保留項目上下文,令每次測試都由相同背景開始。
呢個工作區可以接入 OpenAI、Anthropic 同 Google 等供應商嘅模型。開始測試前,先喺帳戶入面查看最新模型列表。1min.AI 唔會取代你自己嘅評估,只係幫你減少切換成本,令你可以更頻密咁做評估。
最佳 LLM FAQ
以下係讀者之後最常搜尋嘅跟進問題。
邊個 LLM 排名最值得信?
唔好只信一個。獨立指數會顯示能力、價格同速度,而人類偏好對戰平台會顯示聊天質素。一定要睇日期,再用自己嘅測試確認。
邊個係最佳開源 LLM?
要視乎你嘅工作量同硬件而定。幾個開放權重模型而家喺公開基準上已可同專有模型競爭,但最大型嘅需要多節點 GPU 叢集。可按授權、大小同任務匹配度篩選。
邊個係最佳本地 LLM?
對本地使用嚟講,記憶體係主要限制。可按授權、記憶體需求同運行支援比較候選模型,就好似 有來源核實嘅短名單 咁做。Ollama 呢類工具可以喺你自己部機上運行模型。
邊個係最佳免費 LLM?
免費存取經常變動,而且好多供應商都有使用上限。先查看各供應商而家嘅限制,再用你嘅真實提示詞測試免費方案,確定可靠先好依賴。
Claude、Grok 或 DeepSeek 係咪最佳 LLM?
佢哋都可以喺某啲任務上成為強力候選者,但冇一個可以贏晒全部。應該用相同提示詞喺候選名單上做測試,再比較結果,而唔係信品牌聲譽。
Reddit 推薦可信嗎?
社群討論會分享實際感受,但都係軼事。可以用嚟搵測試靈感,但唔可以當成某個模型就一定最好嘅證明。
用真實測試揀出你嘅最佳 LLM
最佳 LLM 係喺你嘅任務上表現出色,而且成本你可以持續承擔嗰個。用排名去建立候選名單,再用真實工作測試兩至三個模型。喺 1min.AI 開始並排比較。
- #Information
替代方案
探索 1minAI 的最佳替代方案,並比較其功能、定價和使用案例。

1min.AI 對比 OpenRouter
1min.AI 對比 OpenRouter:比較即用型 AI 創作產品同技術 API 工具。睇下你需要零程式碼創意工作室,定係編碼基礎設施中樞。
 Ngoc Hong

1min. AI vs Dola AI
想搵 Dola AI 替代方案?比較 1min.AI vs Dola AI 嘅影片生成、免費方案、收費同私隱,揀啱適合你嘅 AI 應用。
Ngoc Hong
1minAI vs Hix AI
比較 5 個 HIX AI 替代方案,涵蓋 AI 聊天、研究、寫作、圖片、影片、定價同靈活 AI 工作流程。
Ngoc HongAI 工具
探索最佳 AI 工具,提升生產力、創造力及日常工作效率。

一個產品,10 個 UGC 創意:AI 點樣令內容測試更輕鬆
用 AI UGC 影片生成器製作更真實嘅 UGC,測試更多創意角度,並喺唔使逐條拍攝嘅情況下擴大聯盟內容規模。
 Lien Anh Vu

只需幾個步驟,即可製作一致的卡通內容
用 1min.AI 透過 3 個簡單步驟製作 TikTok 同 Reels 卡通影片,由研究點子到角色再到動畫影片,一次完成。
Lien Anh Vu
為初創創辦人而設的 4 款最抵用 AI 工具
發掘 4 款最抵用嘅 AI 工具,幫初創創辦人驗證概念、建立產品、製作內容,同埋更快推出市場,而唔使超支。
 Tram Ta
AI 功能
全面的 AI 功能,可簡化工作流程、提升效率,讓團隊達成更多目標。

AI 應用案例
精選 AI 應用案例,涵蓋商業、生產力及各行業專用應用。
一個產品,10 個 UGC 創意:AI 點樣令內容測試更輕鬆
用 AI UGC 影片生成器製作更真實嘅 UGC,測試更多創意角度,並喺唔使逐條拍攝嘅情況下擴大聯盟內容規模。
Lien Anh Vu只需幾個步驟,即可製作一致的卡通內容
用 1min.AI 透過 3 個簡單步驟製作 TikTok 同 Reels 卡通影片,由研究點子到角色再到動畫影片,一次完成。
Lien Anh Vu
Instagram 最佳發帖時間:提升互動的實用指南
了解 Instagram 最佳發帖時間,包括不同受眾的最佳日子和時段,以及如何為你的帳戶找出理想的發帖時間表。
Tram TaAI 教學
透過實用的逐步教學,學習如何使用人工智能。
只需幾個步驟,即可製作一致的卡通內容
用 1min.AI 透過 3 個簡單步驟製作 TikTok 同 Reels 卡通影片,由研究點子到角色再到動畫影片,一次完成。
Lien Anh Vu
2026 黑色星期五 AI 工具優惠
探索 2026 黑色星期五 AI 工具優惠有咩選擇。了解點樣透過 AppSumo、Dealify、Stack Social 搶到 1min.AI 終身方案,並可喺 Trustpilot、Slashdot 同 Software Advice 核實。
 Hang Nguyen

使用 Seedance 的 AI 圖像轉影片產品一致性,停止變形並 масштаб化產品評測
以 AI 圖像轉影片產品一致性停止 logo 變形,立即在 1min.AI 製作 studio 級評測影片。
Lien Anh VuAI 指南
透過實用指南、真實案例和可操作嘅最佳實踐,更快咁學習 AI。
只需幾個步驟,即可製作一致的卡通內容
用 1min.AI 透過 3 個簡單步驟製作 TikTok 同 Reels 卡通影片,由研究點子到角色再到動畫影片,一次完成。
Lien Anh Vu
安全網上購買 AI 工具:2026 黑色星期五指南
了解如何在網上搵到同鎖定最佳黑色星期五 AI 優惠。學習專家策略,避開騙局、應對訂閱疲勞,並驗證軟件。
Hang Nguyen使用 Seedance 的 AI 圖像轉影片產品一致性,停止變形並 масштаб化產品評測
以 AI 圖像轉影片產品一致性停止 logo 變形,立即在 1min.AI 製作 studio 級評測影片。
Lien Anh VuAI 解決方案
瀏覽適用於自動化、編碼、研究、生產力、客戶支援、市場推廣及業務流程的最佳AI解決方案。
一個產品,10 個 UGC 創意:AI 點樣令內容測試更輕鬆
用 AI UGC 影片生成器製作更真實嘅 UGC,測試更多創意角度,並喺唔使逐條拍攝嘅情況下擴大聯盟內容規模。
Lien Anh Vu只需幾個步驟,即可製作一致的卡通內容
用 1min.AI 透過 3 個簡單步驟製作 TikTok 同 Reels 卡通影片,由研究點子到角色再到動畫影片,一次完成。
Lien Anh Vu
免費 AI 紋身生成器:自訂設計
用 1min.AI 的免費 AI 紋身生成器,將任何靈感變成自訂紋身設計。描述你的想法、選擇風格,幾秒內即可下載。
 Trang Tran
AI 模型
於一處探索全球頂尖嘅 AI 模型。
一個產品,10 個 UGC 創意:AI 點樣令內容測試更輕鬆
用 AI UGC 影片生成器製作更真實嘅 UGC,測試更多創意角度,並喺唔使逐條拍攝嘅情況下擴大聯盟內容規模。
Lien Anh Vu只需幾個步驟,即可製作一致的卡通內容
用 1min.AI 透過 3 個簡單步驟製作 TikTok 同 Reels 卡通影片,由研究點子到角色再到動畫影片,一次完成。
Lien Anh Vu使用 Seedance 的 AI 圖像轉影片產品一致性,停止變形並 масштаб化產品評測
以 AI 圖像轉影片產品一致性停止 logo 變形,立即在 1min.AI 製作 studio 級評測影片。
Lien Anh VuAI 比較
比較AI工具、模型及平台,尋找最適合您需求的選擇。

Kling AI 對 Veo 3:邊個模型勝出?
Kling AI 對 Veo 3:比較動態、原生音訊、定價同免費方案,睇下邊個 AI 影片生成器更適合你嘅項目——即刻喺 1min.AI 試晒兩個。
Trang Tran使用 Seedance 的 AI 圖像轉影片產品一致性,停止變形並 масштаб化產品評測
以 AI 圖像轉影片產品一致性停止 logo 變形,立即在 1min.AI 製作 studio 級評測影片。
Lien Anh Vu
DeepSeek V4 Pro 與 Flash 比較
比較 DeepSeek V4 Pro 與 DeepSeek V4 Flash 的指標。立即喺 1min.ai 優化你嘅 agentic apps,同提升 AI fact checking。
Ngoc HongAI 整合
將 AI 無縫整合到你現有的工具中,自動化工作並提升生產力。

如何使用 AI 時尚影片生成器製作 2026 時裝週內容
用 AI 將 2026 時裝週靈感變成驚艷時尚影片。學習如何發想、創作視覺,並以一個簡單流程將圖片轉成影片。
Lien Anh Vu
POV:你每日要製作 10+ 篇貼文
了解如何建立 AI 內容工作流程,幫助內容創作者透過 AI 發想、圖片生成同內容製作,更快每日產出 10+ 則社交媒體貼文。
Lien Anh Vu
停止在 AI 應用程式之間切換:AI 整合如何重塑僱主品牌
了解 AI 整合如何透過將 AI 寫作、文件、圖像、影片及多個 AI 模型整合到同一工作空間,幫助 HR 團隊簡化僱主品牌工作。
Tram Ta行業AI
為醫療保健、金融、教育、法律、製造、零售、房地產等行業尋找最佳AI工具和工作流程。

免費 AI 產品描述生成器
幾分鐘內寫出能帶來銷售的產品描述。使用這個免費 AI 產品描述生成器,將產品資料或相片轉成符合品牌的文案。試用 1min.AI。
Trang Tran
助初創企業提升利潤的最佳商業生產力工具 | 1minAI
探索最適合初創企業的商業生產力工具,節省時間、簡化工作流程、減少重複工作,並透過 AI 支援有利可圖的增長。
Tram Ta
最佳內容行銷 AI 工具|1minAI
搵緊最佳內容行銷 AI 工具?睇吓 1minAI 點樣幫市場人員喺同一個 AI 工作空間內做資料研究、寫作、重製內容、製作視覺素材同擴大產出。
Tram TaAI 代理
探索並運行 AI 代理,自動化您的工作和日常生活中的任務。


AI 工作流程
探索現成可用的 AI 工作流程,適用於生產力、營銷、銷售、支援等。
一個產品,10 個 UGC 創意:AI 點樣令內容測試更輕鬆
用 AI UGC 影片生成器製作更真實嘅 UGC,測試更多創意角度,並喺唔使逐條拍攝嘅情況下擴大聯盟內容規模。
Lien Anh Vu只需幾個步驟,即可製作一致的卡通內容
用 1min.AI 透過 3 個簡單步驟製作 TikTok 同 Reels 卡通影片,由研究點子到角色再到動畫影片,一次完成。
Lien Anh Vu如何使用 AI 時尚影片生成器製作 2026 時裝週內容
用 AI 將 2026 時裝週靈感變成驚艷時尚影片。學習如何發想、創作視覺,並以一個簡單流程將圖片轉成影片。
Lien Anh Vu電子報
1minAI 每週 AI 創新

🔮 每週 AI 創新 #141:Seedance 2.5 與 Stable Audio 3:新一代 AI
在 1min.ai 探索 Seedance 2.0、2.5 以及 StabilityAI 的 Stable Audio 3。運用新一代生成式 AI 生成錄音室級音訊與同步動作。
Hang Nguyen
🔮 每週 AI 創新 #121:Ideogram 3.0 同 Claude Opus 4.7 現已於 1min.ai 上線
Ideogram 3.0 同 Claude Opus 4.7 現已於 1min.ai 上線。喺一個平台同時生成完美嘅圖片排版同進階文案。
 Uyen Hoang

🔮 每週 AI 創新 #134:在 AI Chat 體驗免費 Qwen;3.7 及 3.6 系列更新
想搵一個強大又免費嘅 AI 助手?立即探索 1min.ai 上最新嘅 Qwen 3.7 同 3.6 系列。今日零成本享受高速、準確嘅 AI 對話!
Hang Nguyen